Projet de Thèse
IMRaD Analyzer : Microservices Distribués pour la Classification de Textes Scientifiques
Une plateforme de 8 microservices exploitant BERT et Gemini Pro pour classifier des articles scientifiques, avec un dataset personnalisé de 169k phrases atteignant un F1-score de 98,21%.
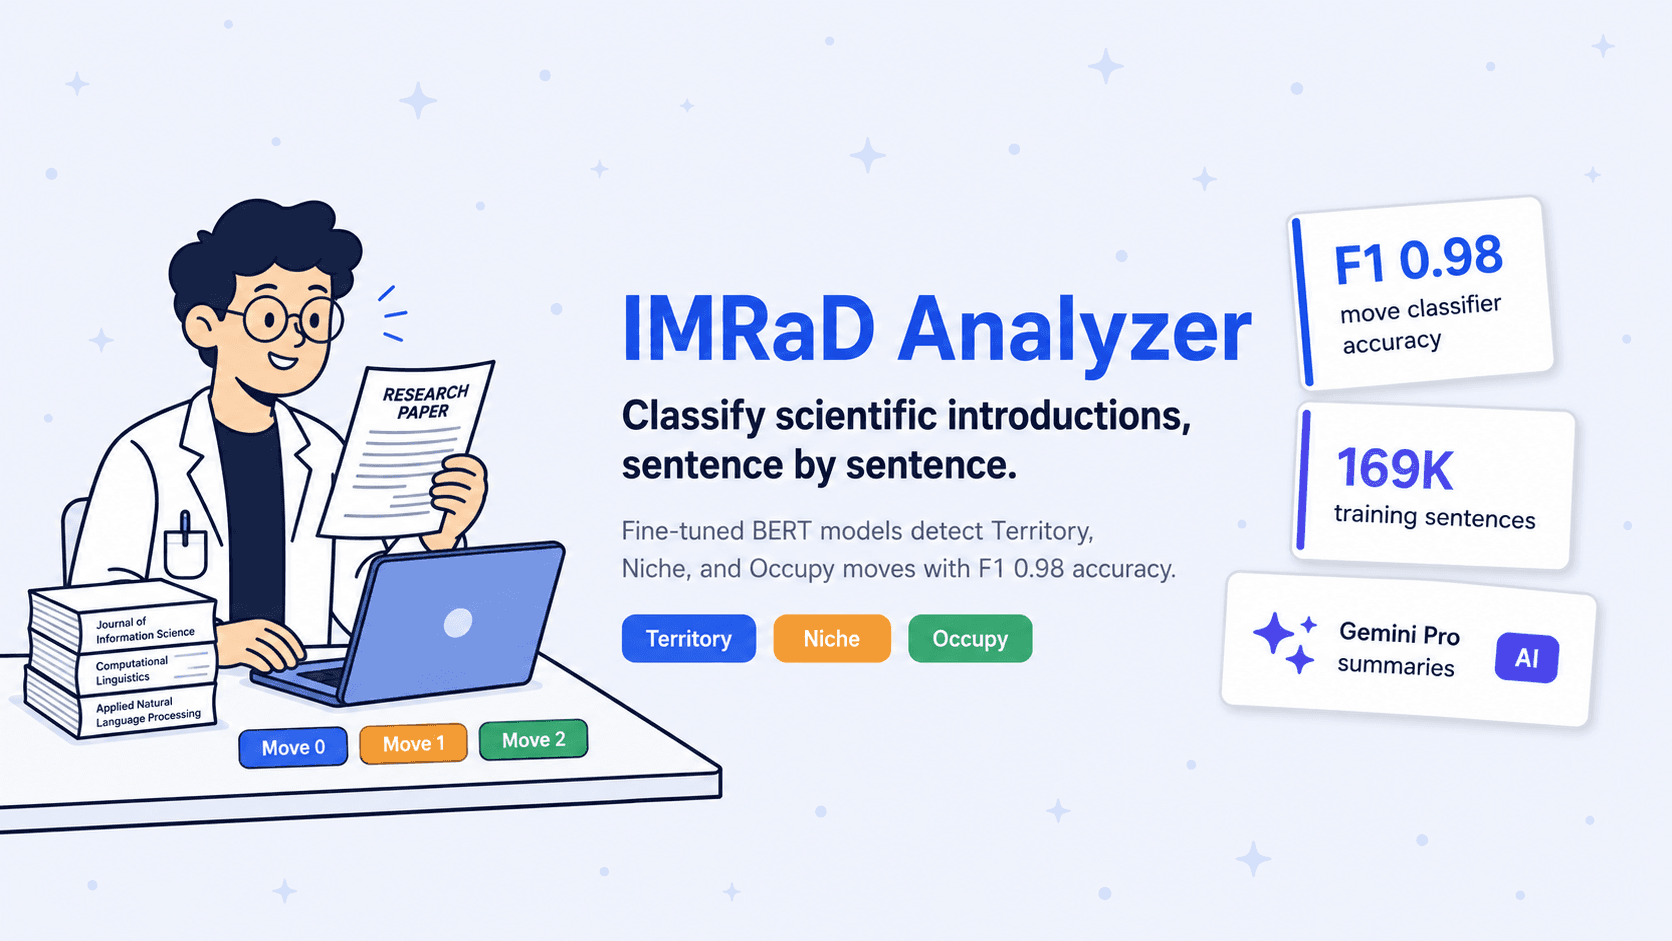
Architecture de 8 microservices
- Nginx (gateway)
- Spring Cloud Eureka (découverte de services)
- Next.js (frontend et API)
- Extracteur PDF (FastAPI)
- TensorFlow Serving
- Microservices IA des mouvements et sous-mouvements (FastAPI avec LangChain)
- Microservice des données utilisateurs (MongoDB, Express.js)
- Redis comme broker de messages.
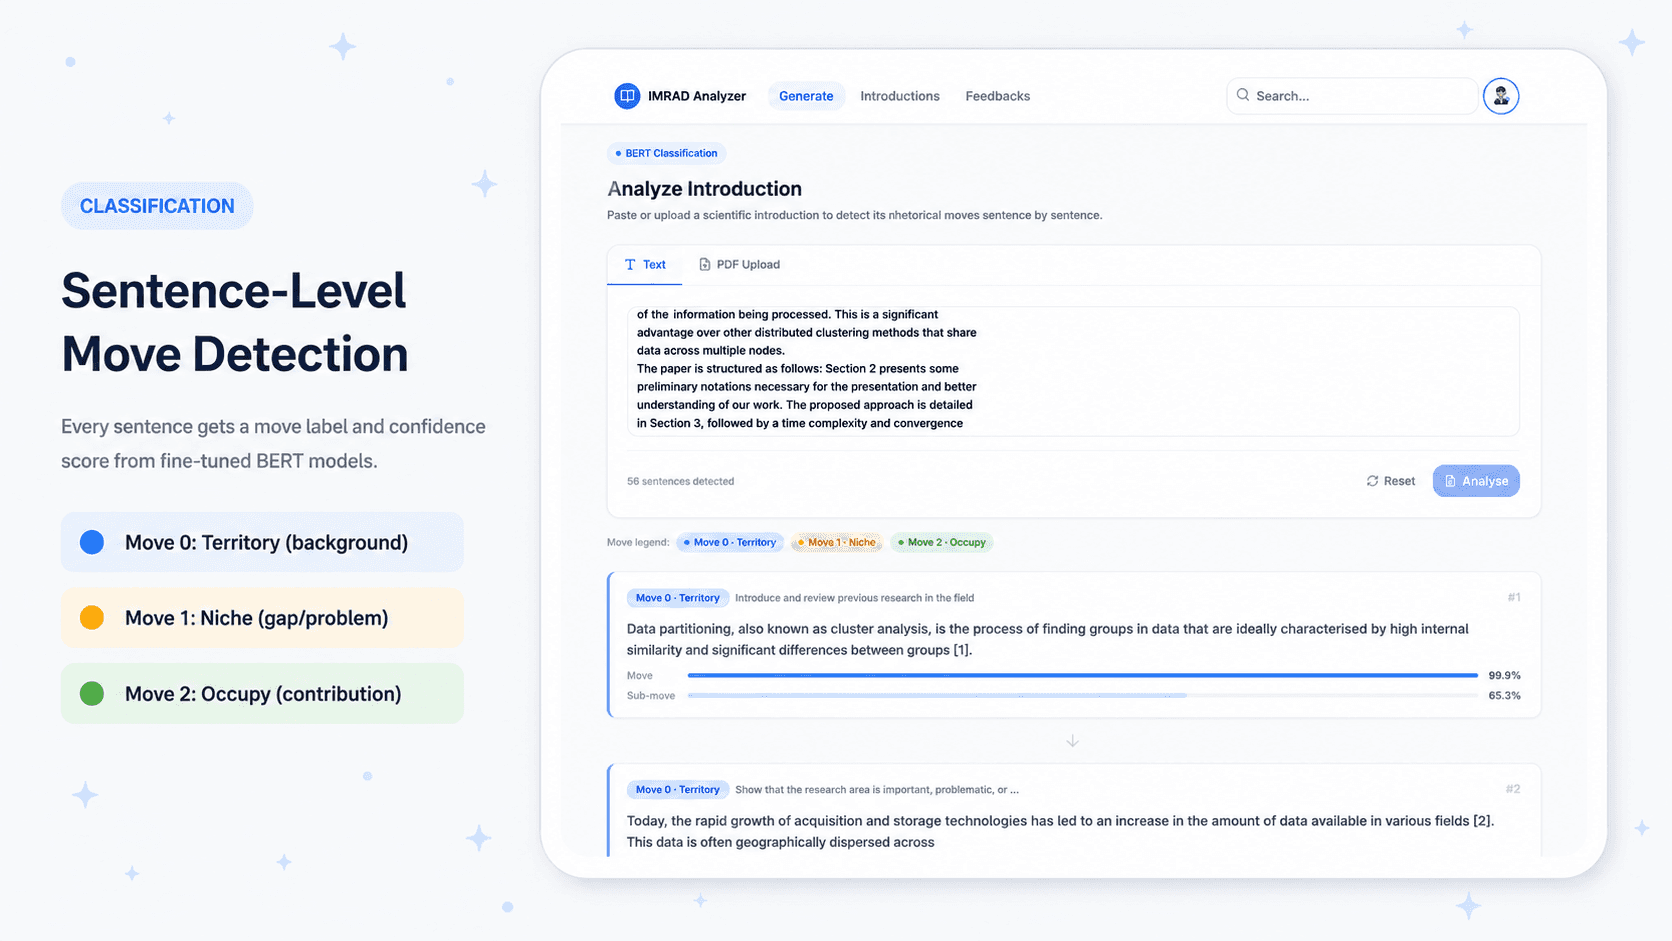
Détection des mouvements phrase par phrase
- Chaque phrase d'une introduction scientifique reçoit son mouvement IMRaD (Territoire / Niche / Occupation) et son sous-mouvement, en temps réel.
- Des badges colorés (bleu, ambre, vert) et une barre de confiance par phrase rendent les résultats lisibles d'un coup d'œil.
- Une cascade de quatre modèles BERT hiérarchiques affinés, servie par TensorFlow Serving, porte tout le pipeline.
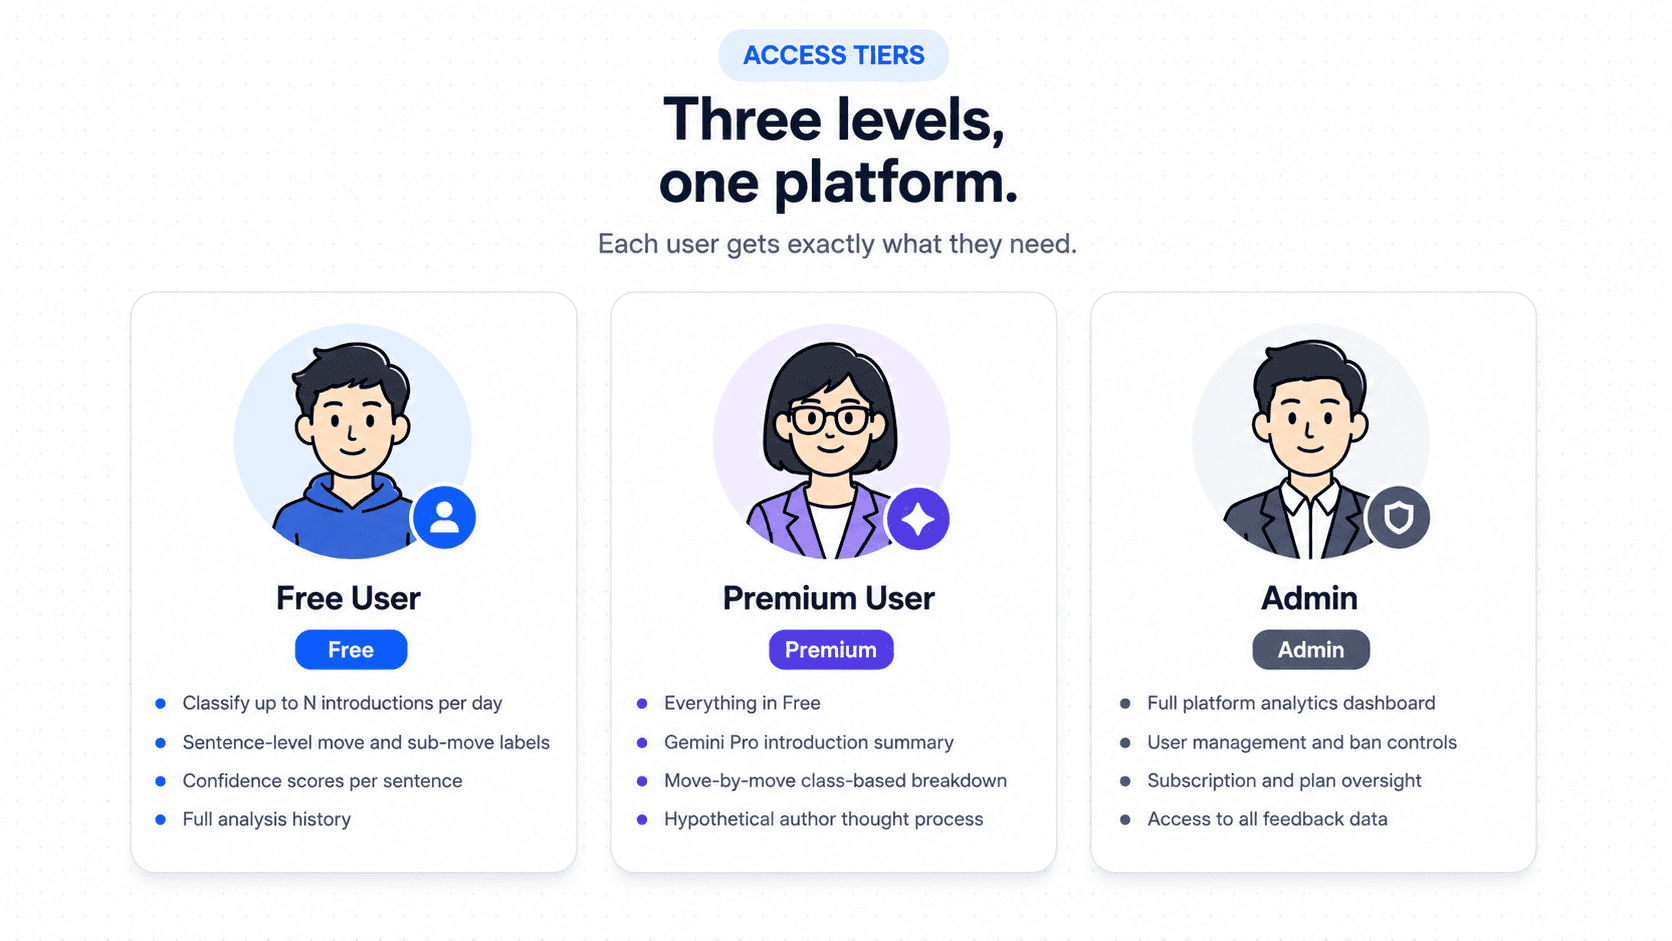
Trois niveaux d'accès
- Les utilisateurs gratuits classent des introductions, voient les étiquettes et scores de confiance par phrase, et tout leur historique.
- Les utilisateurs premium débloquent le résumé Gemini Pro, l'analyse par mouvement et le raisonnement supposé de l'auteur.
- Les administrateurs ont les statistiques de la plateforme, la gestion des utilisateurs et des abonnements, et tous les retours.
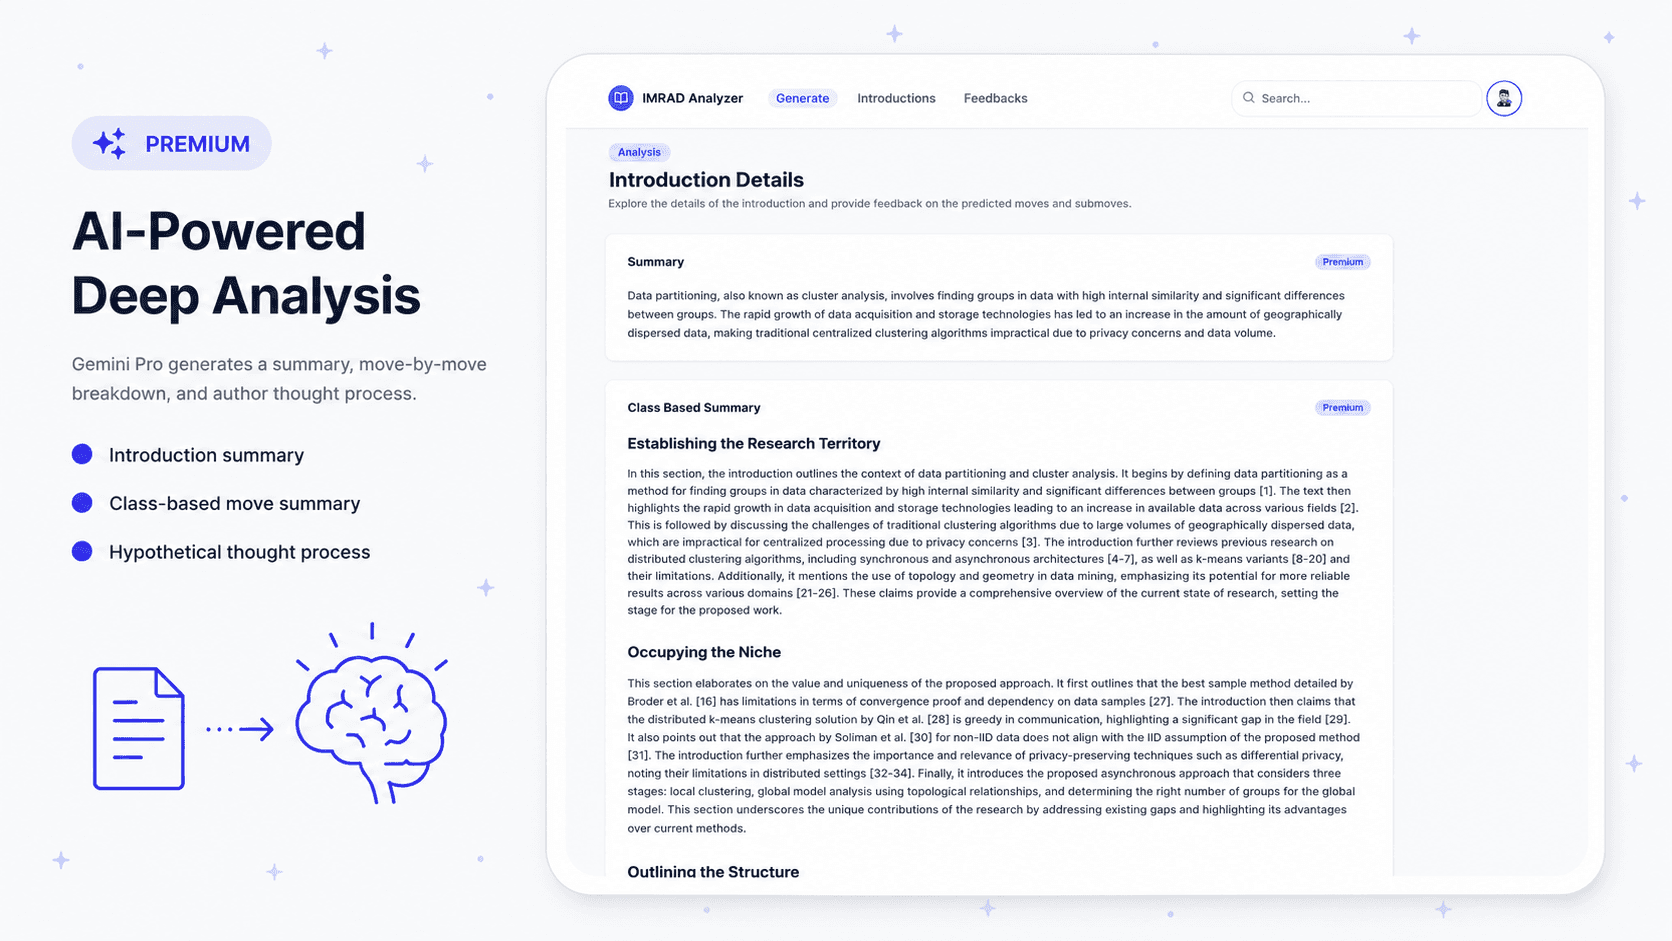
Analyse approfondie par IA
- Les utilisateurs premium reçoivent un résumé de l'introduction généré par Gemini Pro, une analyse mouvement par mouvement et le raisonnement supposé de l'auteur.
- Les trois sections arrivent en flux asynchrone via Redis pub/sub : les résultats s'affichent au fur et à mesure, sans blocage.
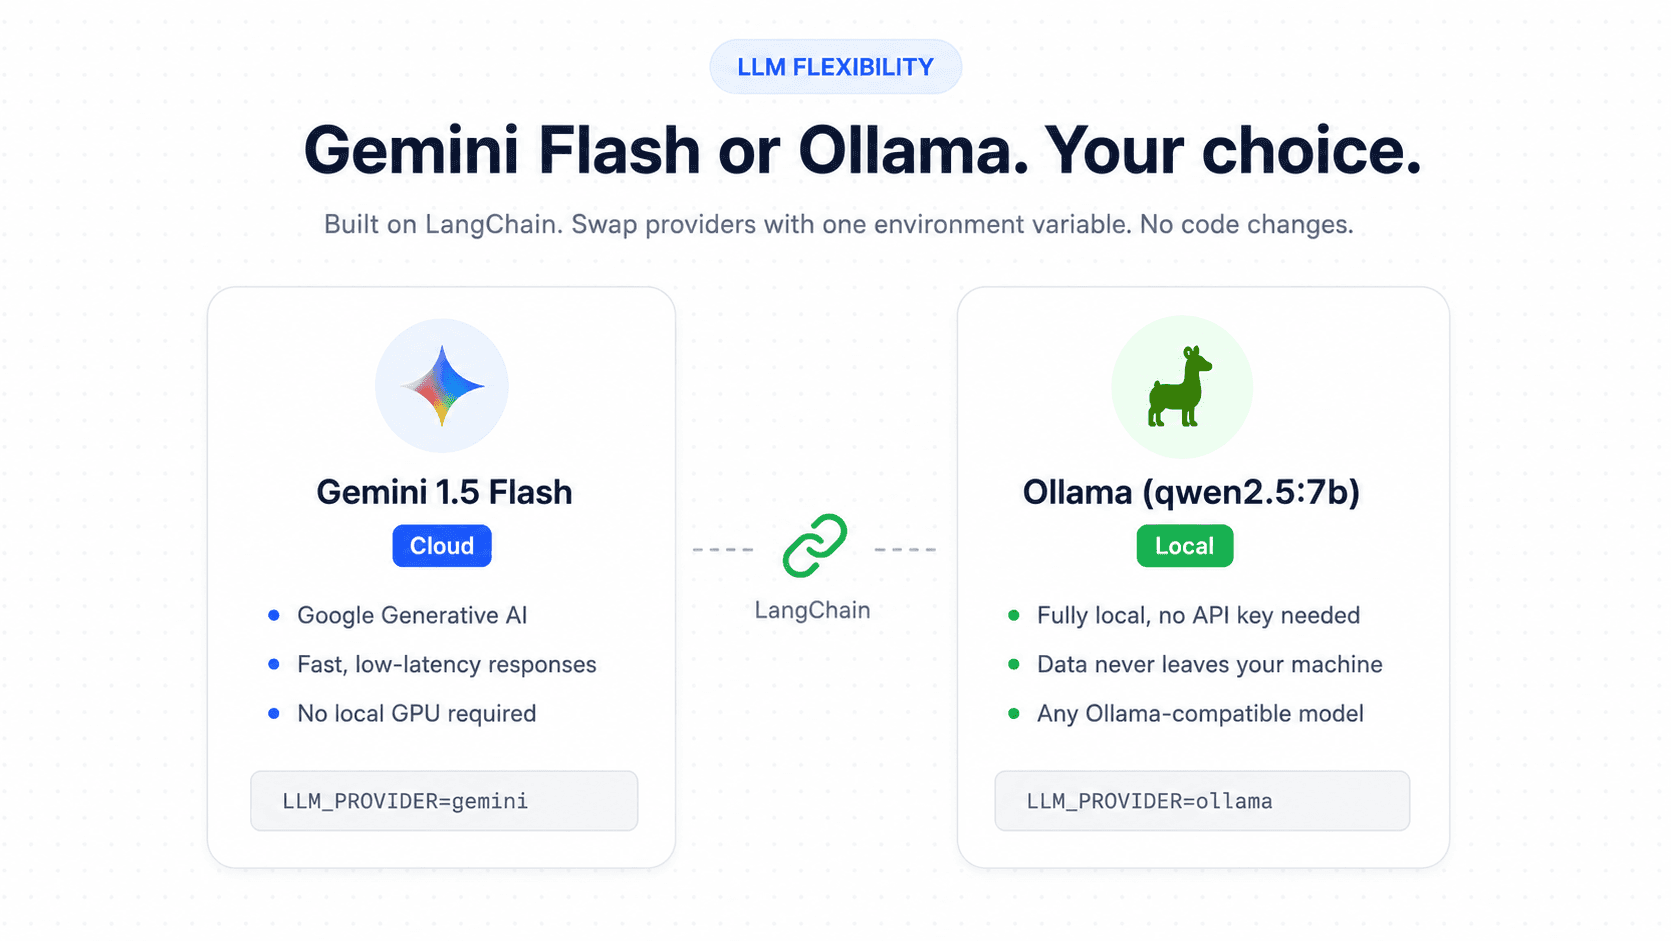
- Construite sur LangChain, la couche IA passe de Gemini Flash à un modèle Ollama entièrement local avec une seule variable d'environnement.
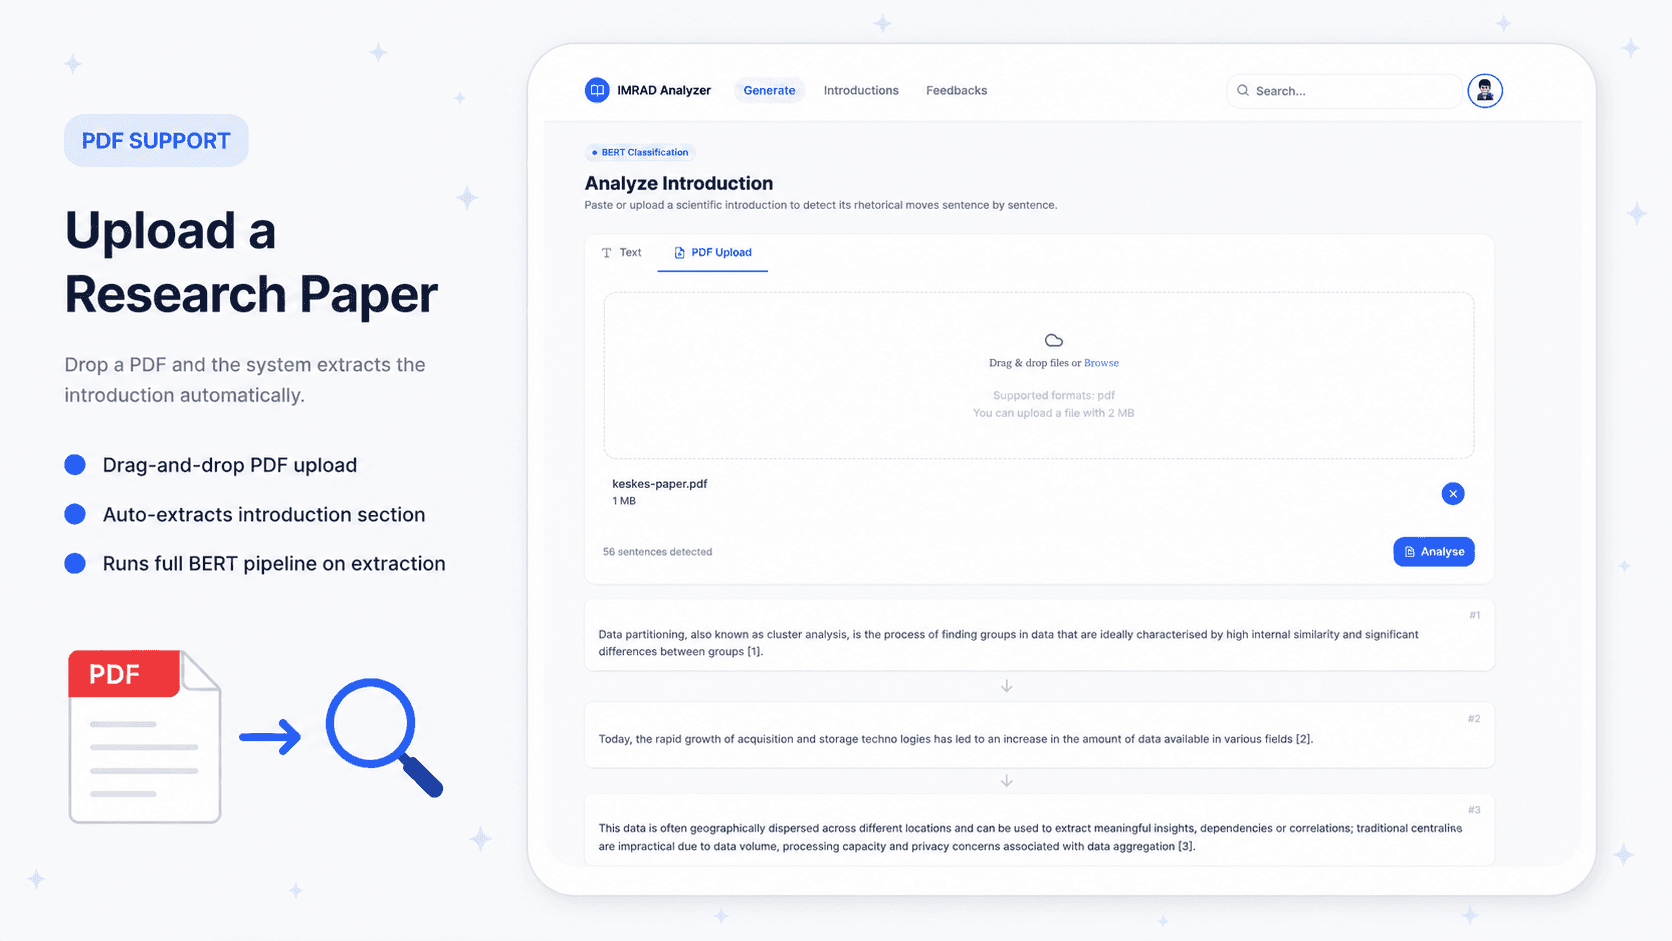
Import et extraction de PDF
- L'utilisateur glisse-dépose un article en PDF et le système en extrait automatiquement l'introduction.
- Un microservice FastAPI dédié gère l'extraction, puis transmet le texte au pipeline de classification BERT.
- La classification phrase par phrase tourne sur l'introduction extraite, sans copier-coller manuel.
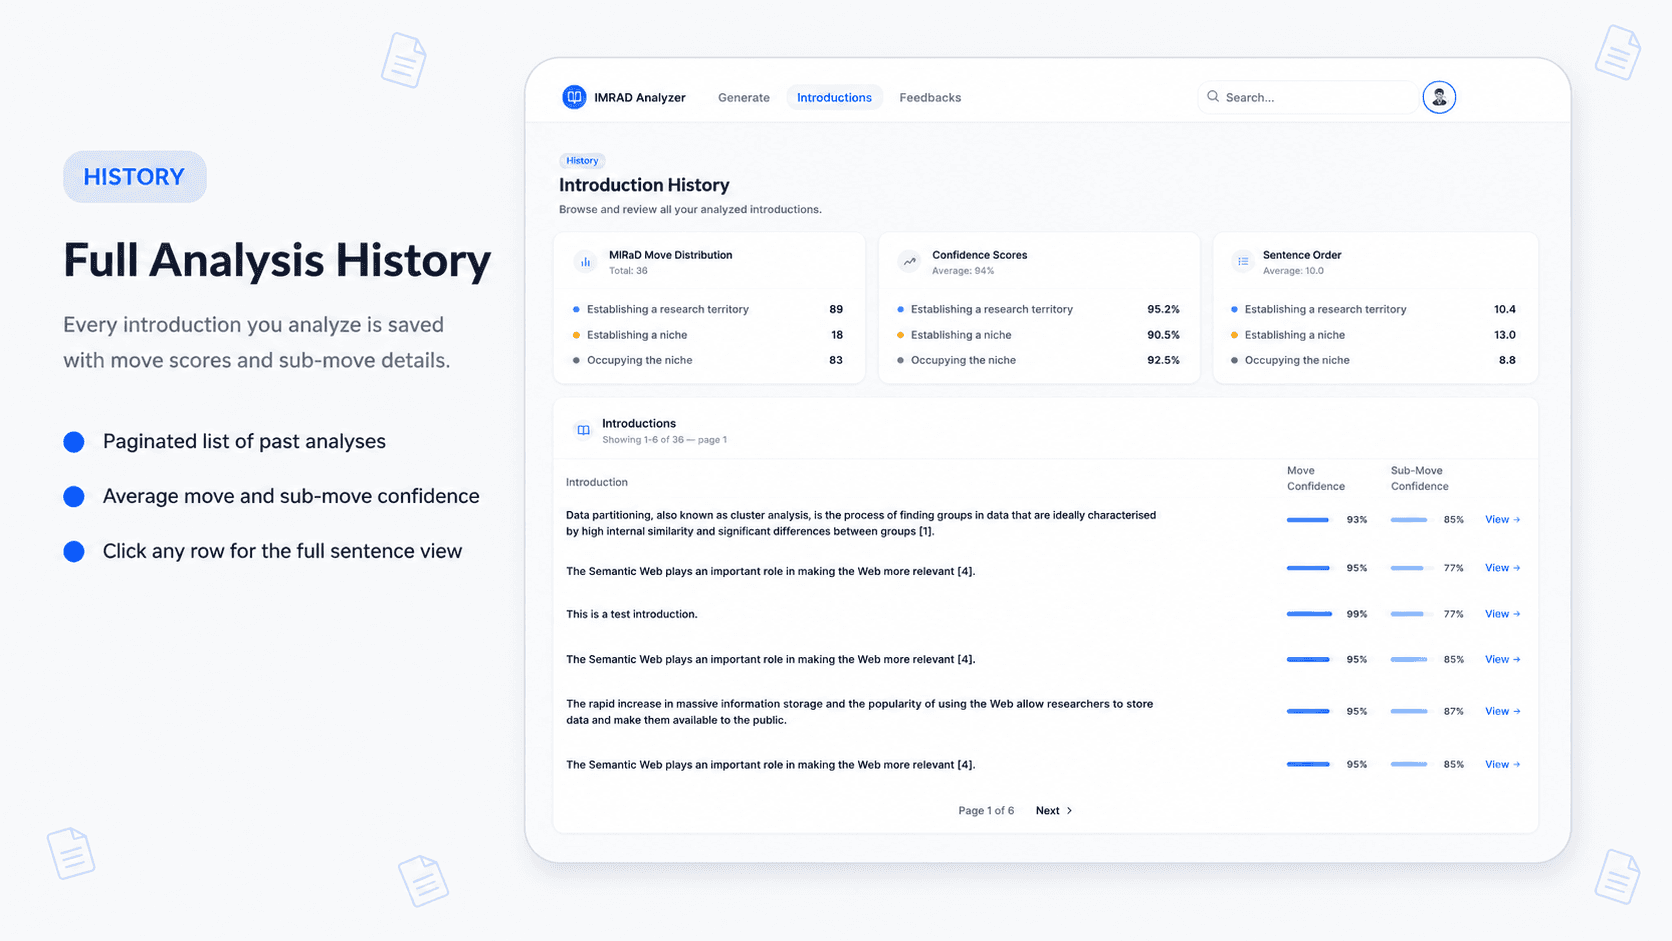
Historique complet des analyses
- Chaque introduction analysée est enregistrée avec ses scores moyens de confiance par mouvement et sous-mouvement, et sa date.
- Une liste paginée mène directement au détail phrase par phrase de chaque analyse passée.
- L'utilisateur suit dans le temps comment différents articles se répartissent entre Territoire, Niche et Occupation.
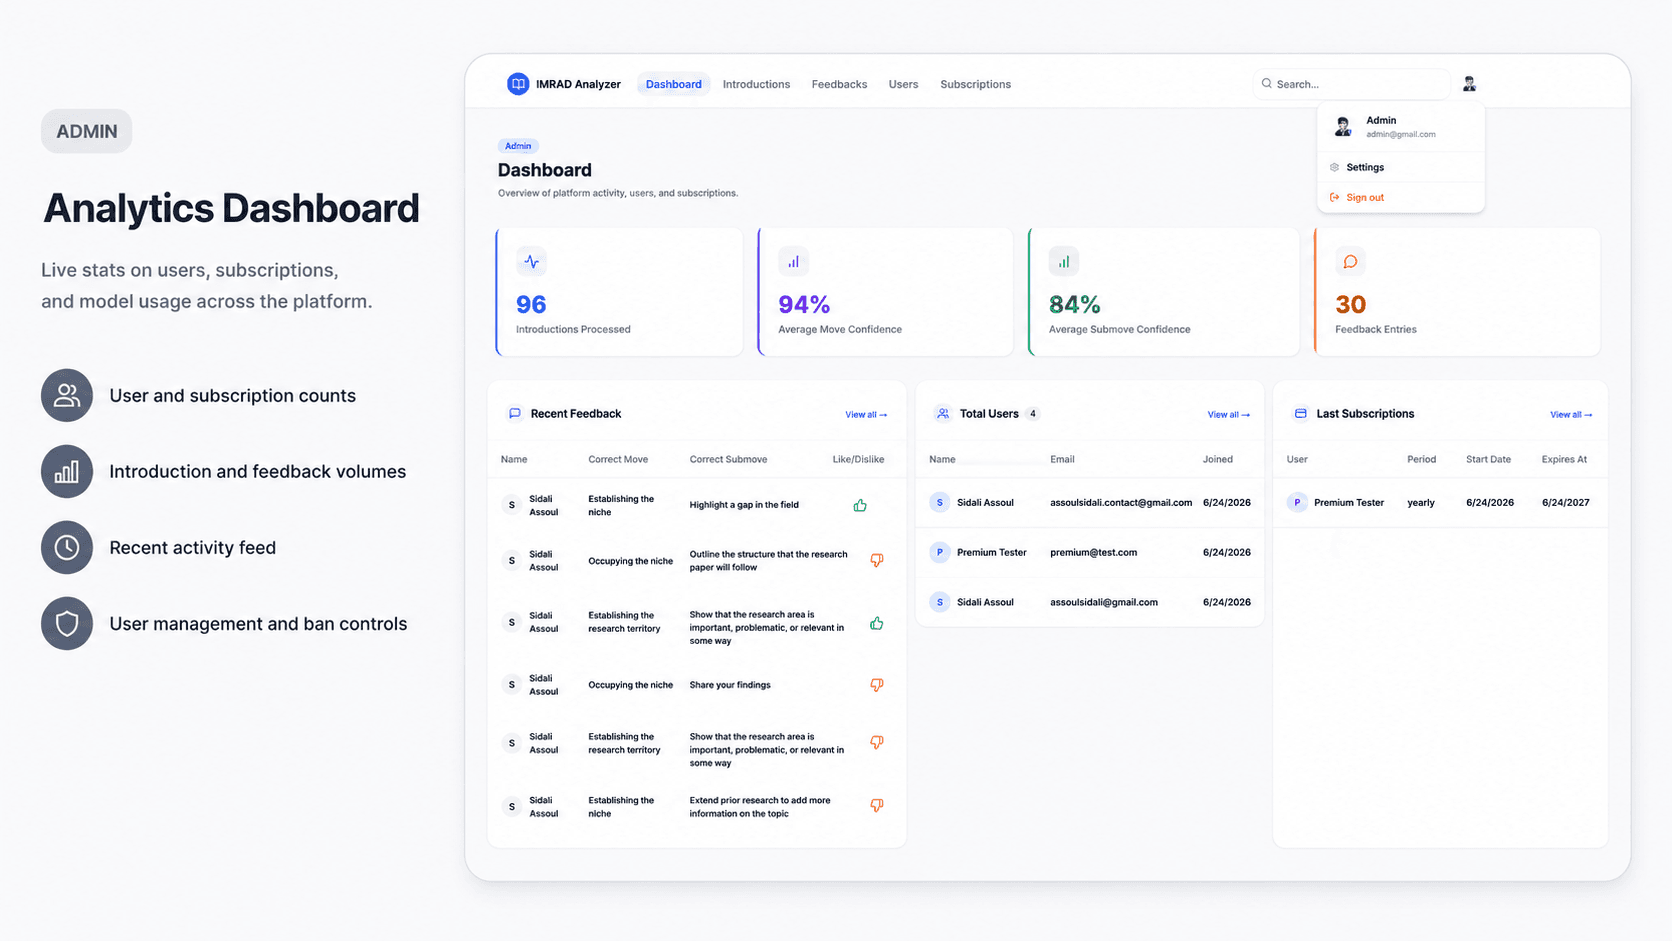
Tableau de bord analytique
- Des cartes en direct affichent le nombre d'utilisateurs, d'abonnés premium, d'introductions analysées et de retours collectés.
- Des graphiques et un fil d'activité récente donnent aux administrateurs une vue en temps réel de l'usage de la plateforme.
- La gestion des utilisateurs et les bannissements sont accessibles depuis la même page.
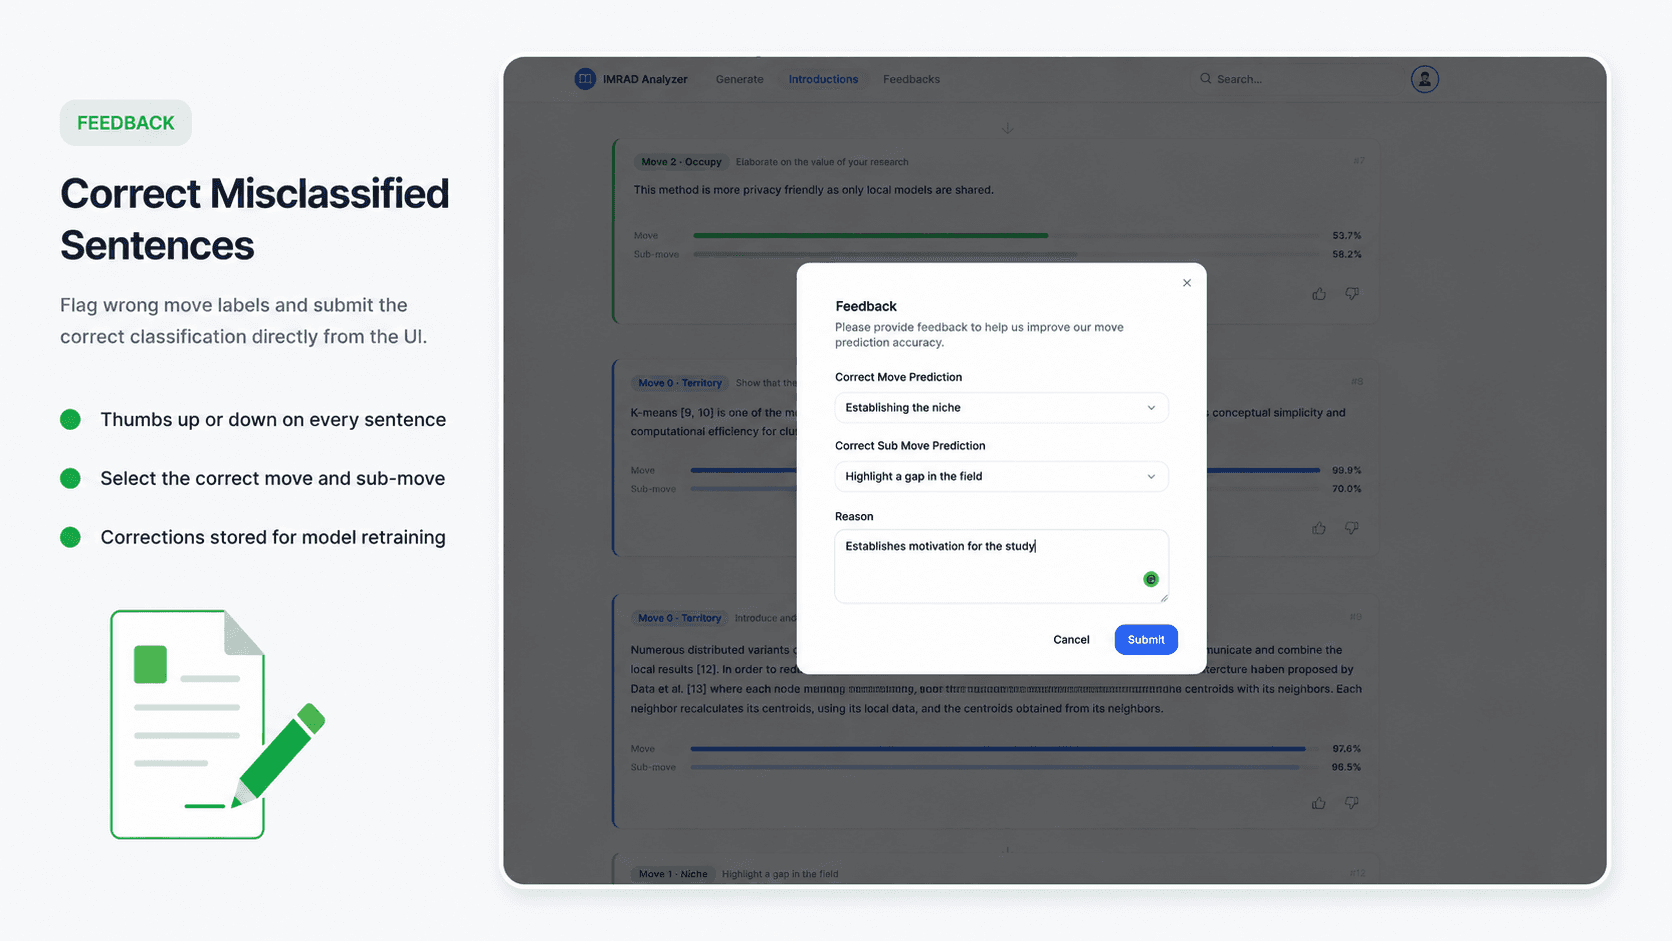
Corriger les phrases mal classées
- L'utilisateur signale une classification erronée directement depuis la page de l'introduction, avec un pouce levé ou baissé.
- Une fenêtre de correction permet de choisir le bon mouvement et sous-mouvement avant l'envoi.
- Chaque correction est conservée et renvoyée au pipeline de réentraînement BERT pour boucler la qualité du modèle.
Exporter les retours et réentraîner
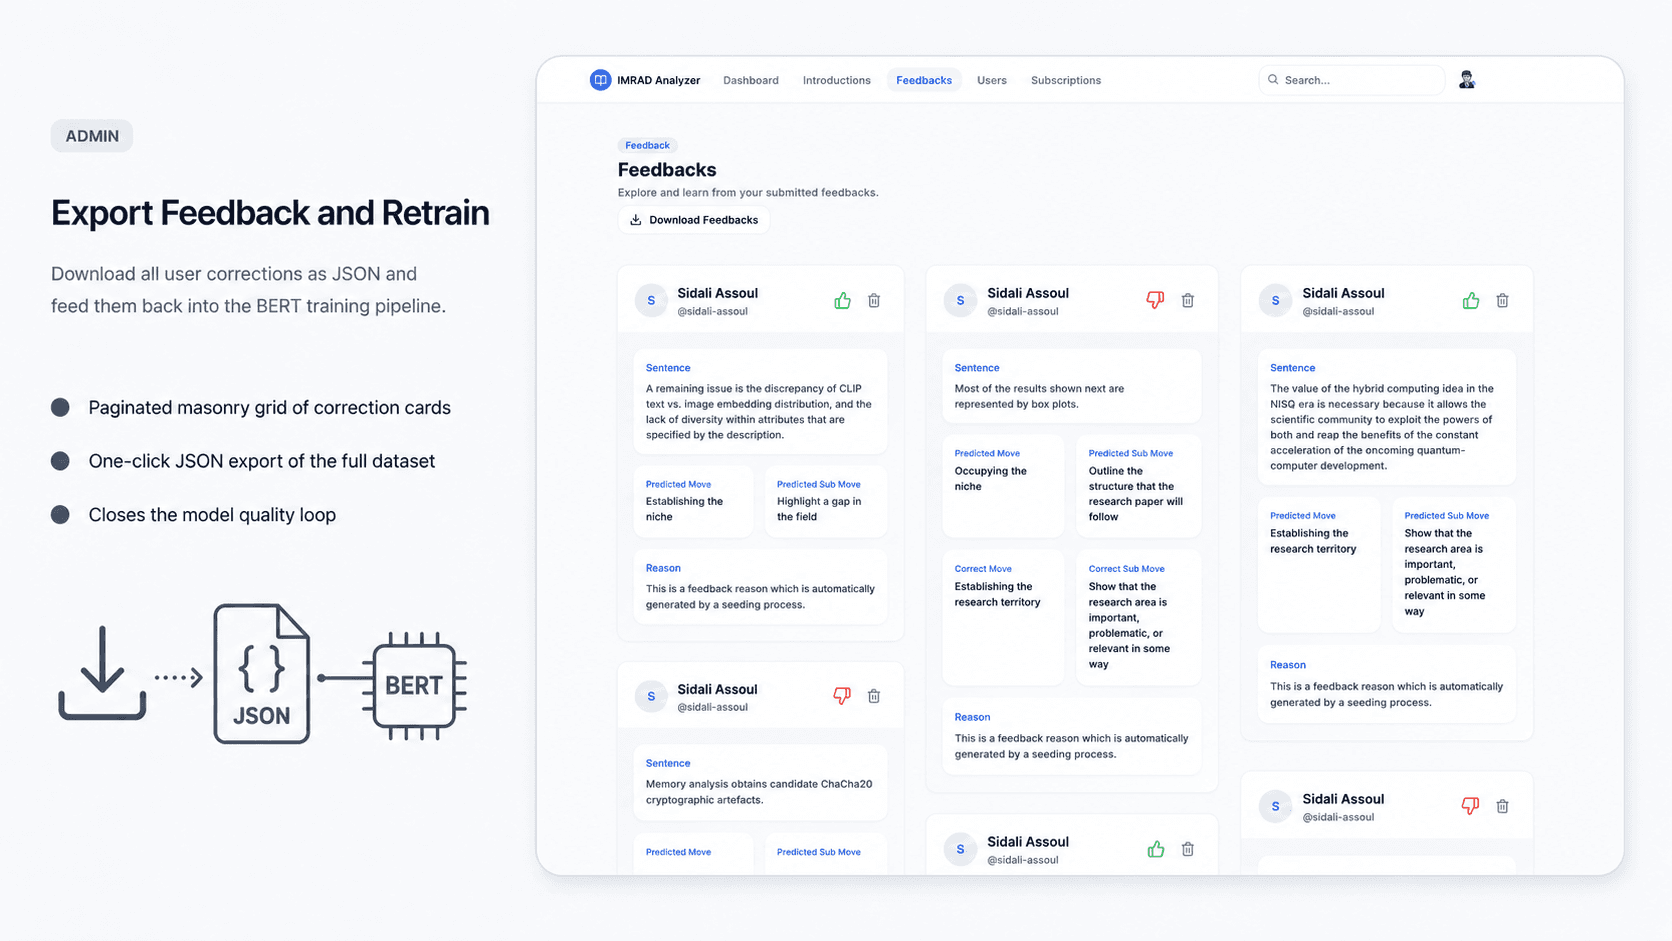
- Les administrateurs parcourent toutes les corrections des utilisateurs dans une grille paginée de cartes.
- Un export JSON en un clic télécharge l'ensemble des corrections pour le pipeline d'entraînement BERT.
- Les vraies erreurs de classification reviennent ainsi dans l'affinage du modèle.
Backend LLM flexible via LangChain
- La couche d'analyse IA repose sur LangChain et propose deux fournisseurs, interchangeables par une seule variable d'environnement.
- LLM_PROVIDER=gemini utilise Gemini 1.5 Flash via l'API Google, LLM_PROVIDER=ollama une inférence entièrement locale.
- Aucun changement de code pour changer de fournisseur ; tout modèle compatible Ollama fonctionne directement.
Notes d'implémentation
- Résolu le manque de datasets IMRaD au niveau des phrases en concevant un pipeline Gemini Pro en 3 étapes (génération de référence, affinement des prompts, détection et augmentation des anomalies).
- Conçu une architecture microservices évolutive à 8 nœuds utilisant Nginx (gateway), Spring Cloud Eureka (discovery), Next.js (frontend et API), FastAPI extracteur PDF, Tensorflow Serving, FastAPI avec LangChain (analyse IA) et Express.js avec MongoDB (données utilisateurs) séparés par un broker Redis.
- Construit un dataset personnalisé de 169k phrases améliorant la précision de base de 44,61% à >94% (F1 de pointe : 98,21%) grâce à 4 modèles BERT hiérarchiques.
Projets Phares
Open Source
Émulateur Web du Processeur 8086
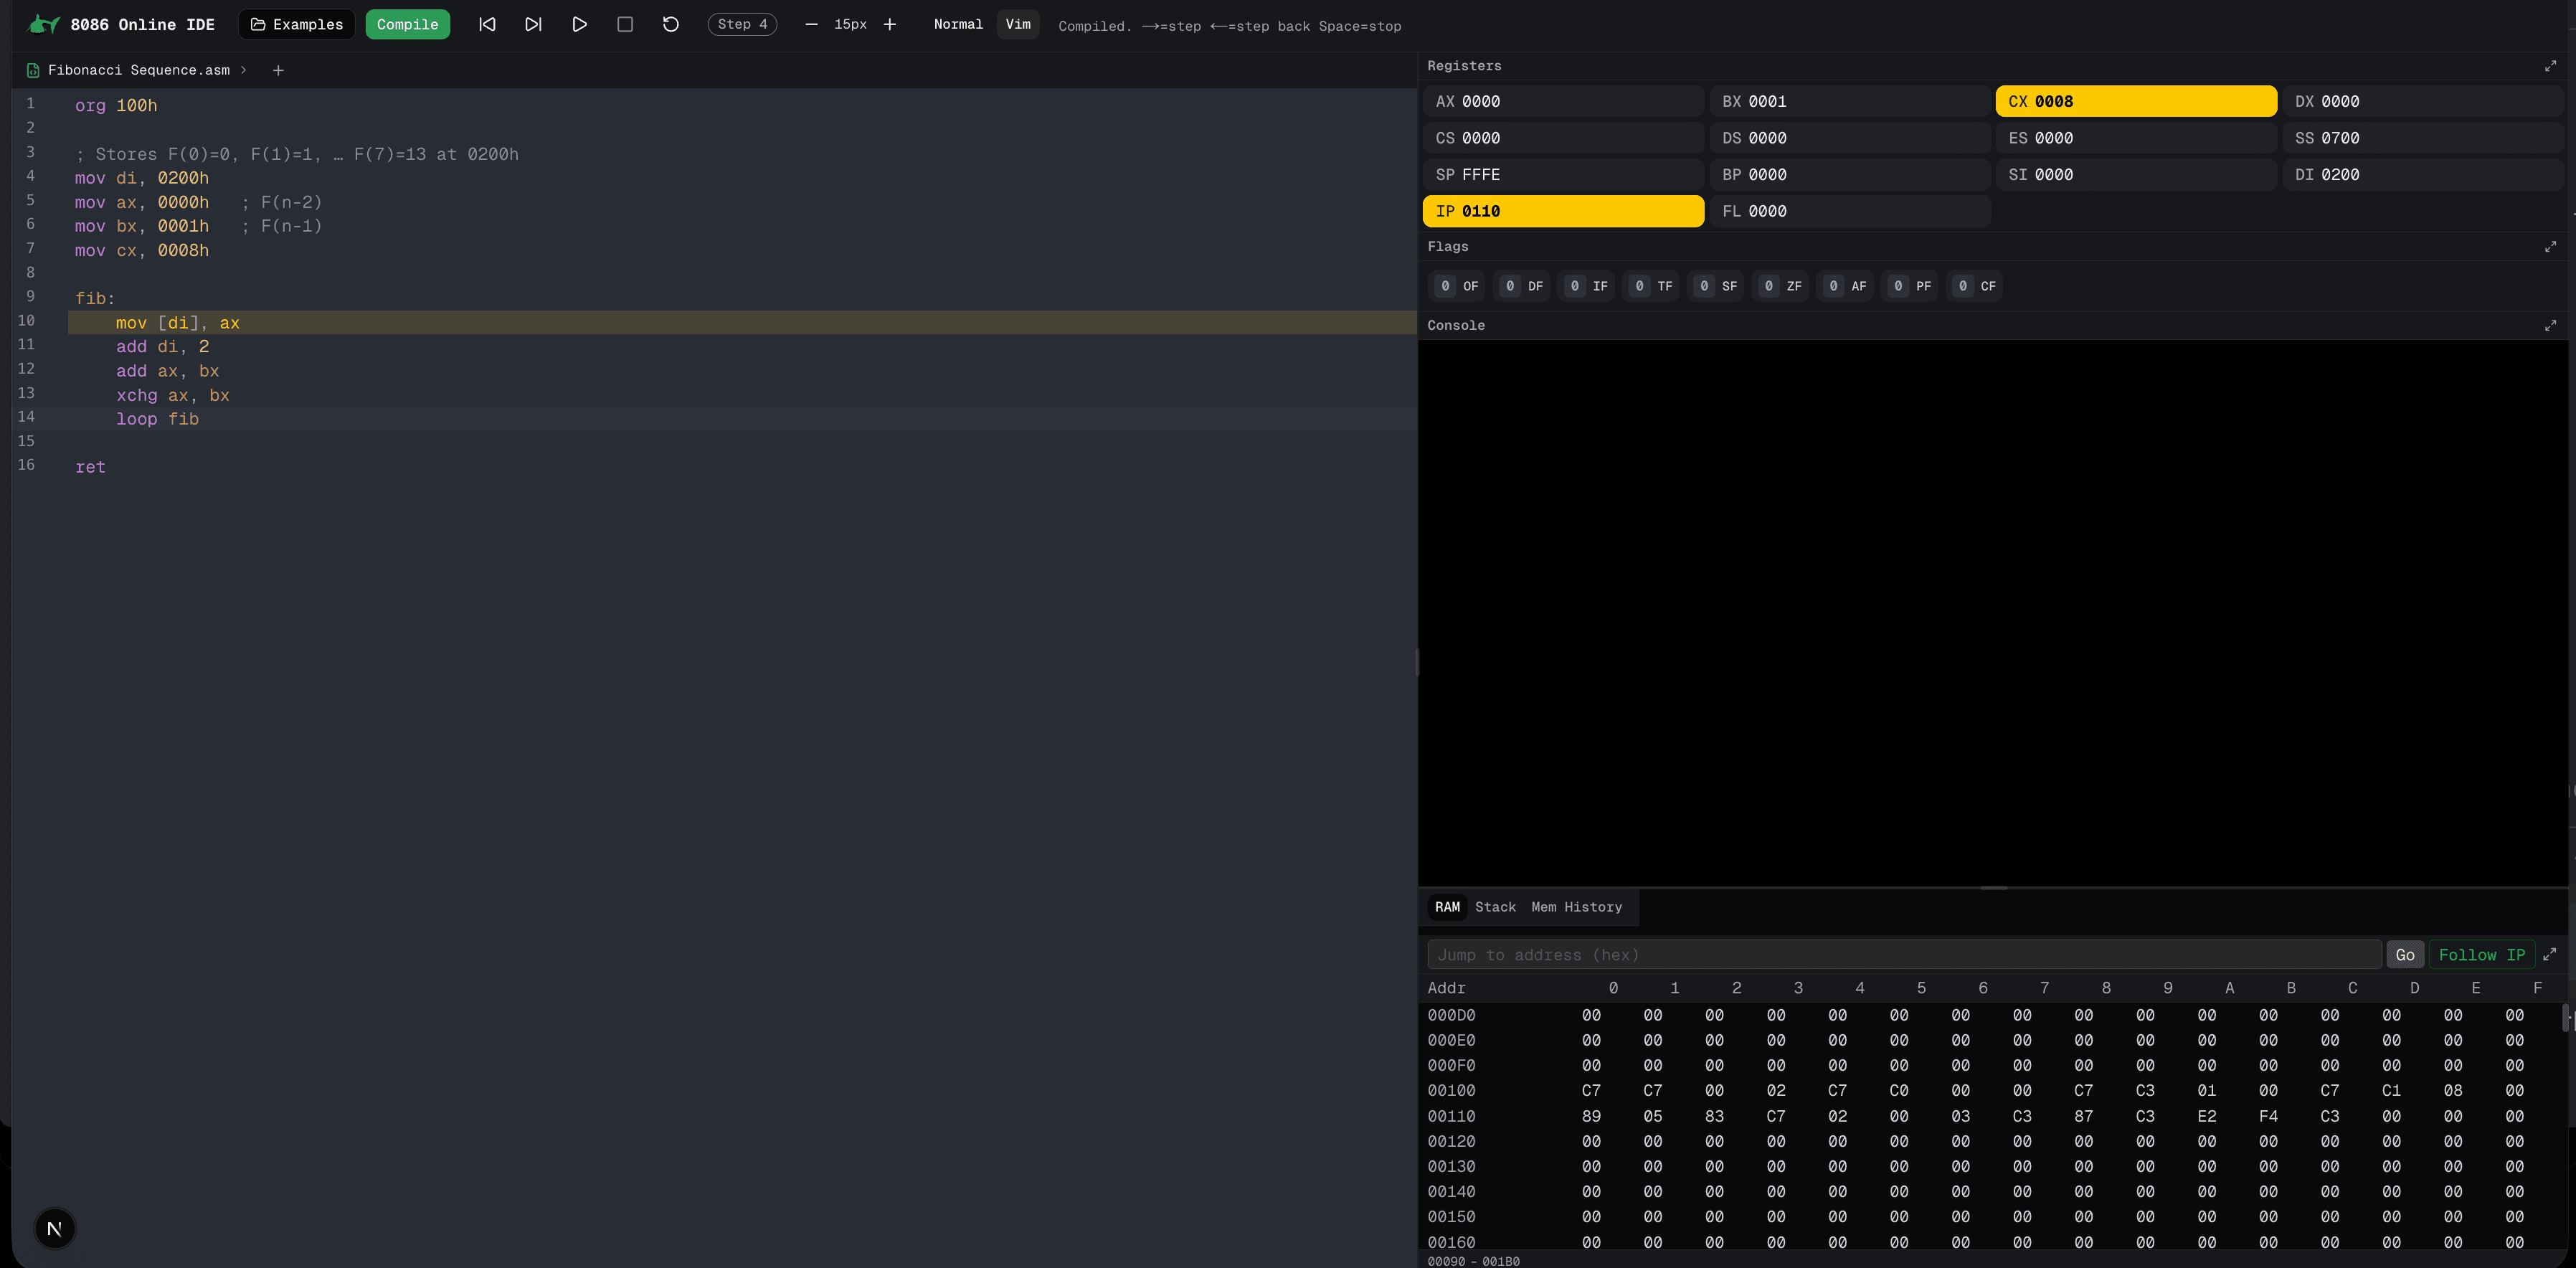
Émulateur et assembleur Intel 8086 open-source pour le navigateur (Vanilla JS), réalisé comme projet pluridisciplinaire de 2ᵉ année à l'université en équipe de 6, avec simulation du jeu d'instructions et débogage interactif.
- JavaScript
- HTML
- CSS
Projet Client
Système de Gestion des Contrats
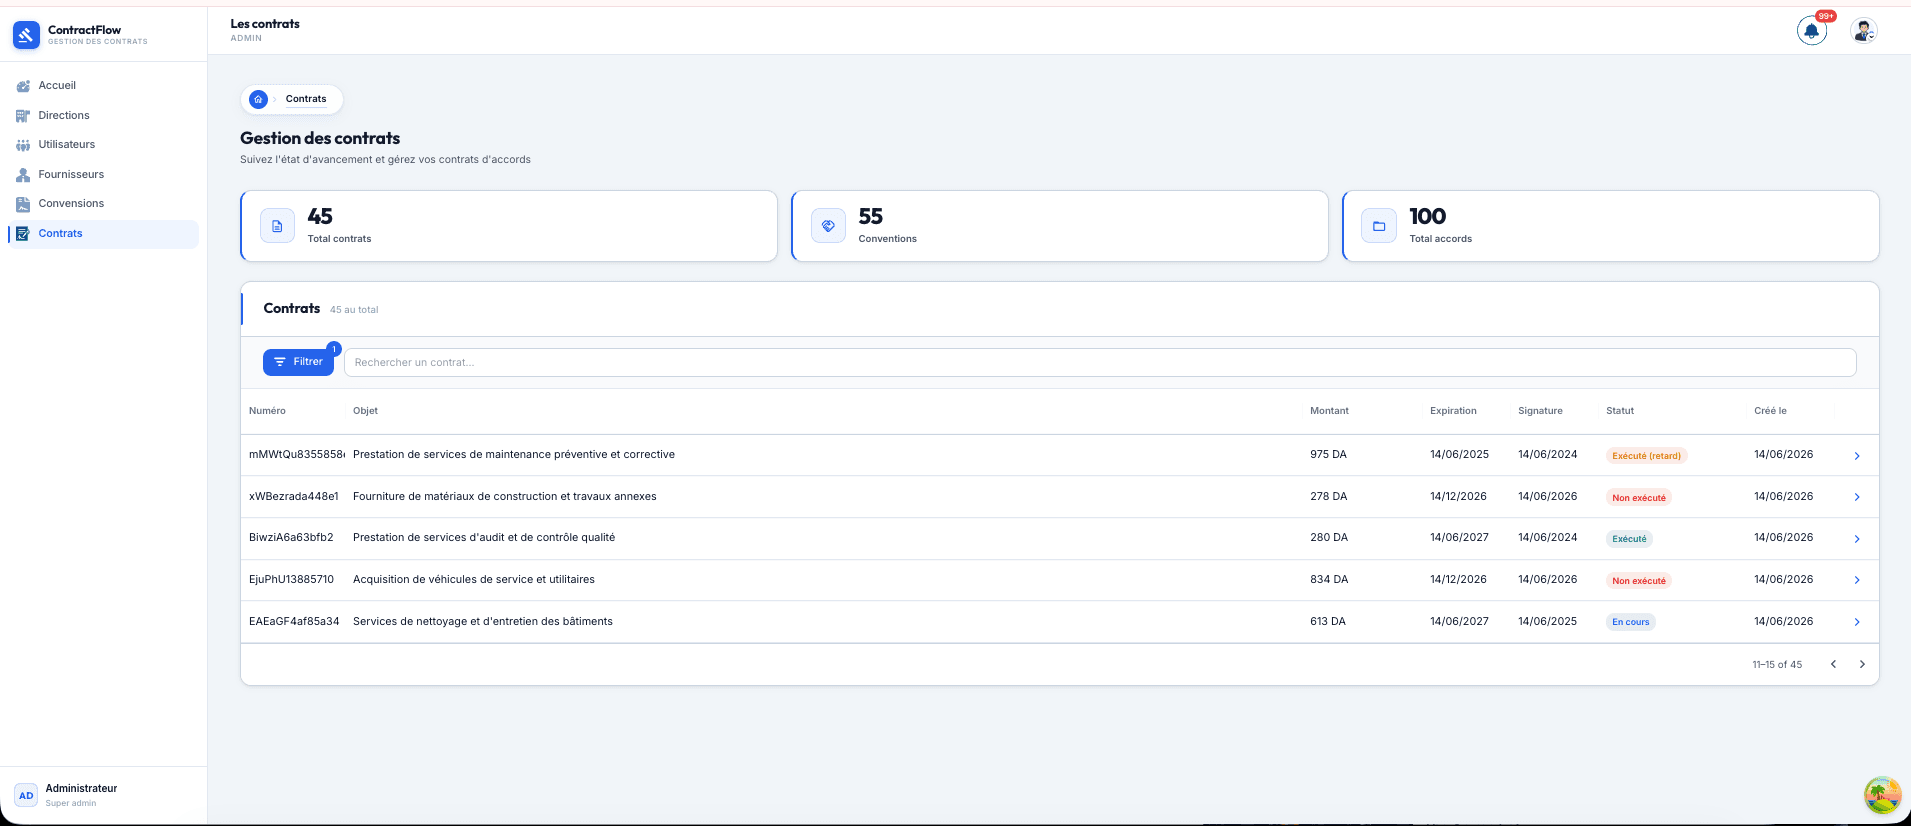
Tableau de bord temps réel pour la société portuaire de Béjaïa avec Clean Architecture, DDD et Redis Pub/Sub pour le scaling horizontal des WebSockets. Couverture complète en tests unitaires et d'intégration.
- NestJS
- Next.js
- PostgreSQL
- TypeORM
- Redis
Travaillons ensemble
Je suis actuellement ouvert à de nouveaux postes, en télétravail ou à l'international. Si vous construisez quelque chose d'ambitieux, j'adorerais en entendre parler.