Produit Personnel
Vocabulary Builder (Produit Personnel)
Une application cross-platform d'apprentissage du vocabulaire déployée sur web et Android, construite avec TypeScript, Expo et Domain Driven Design. Fonctionnalités : révisions par répétition espacée (SM-2), narration podcast mains-libres, suivi bilingue (EN/FR) avec définitions et phrases de contexte, et sauvegarde offline-first avec synchronisation ZIP, sans aucune dépendance cloud.
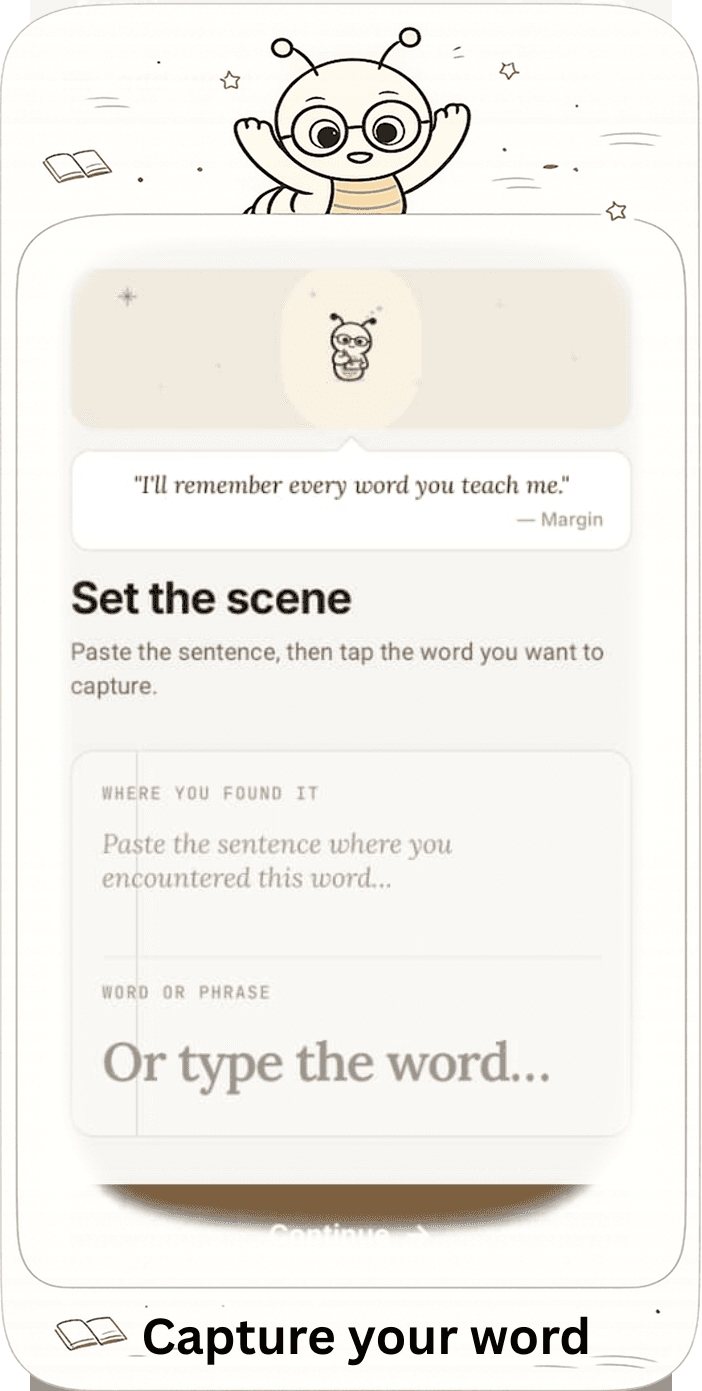
Ajouter des mots avec contexte
- Présente le workflow principal pour ajouter du vocabulaire avec définitions et exemples.
- Supporte le suivi bilingue EN/FR depuis une même expérience mobile.
- Stocke les mots localement via le modèle domaine et la couche repository partagée.
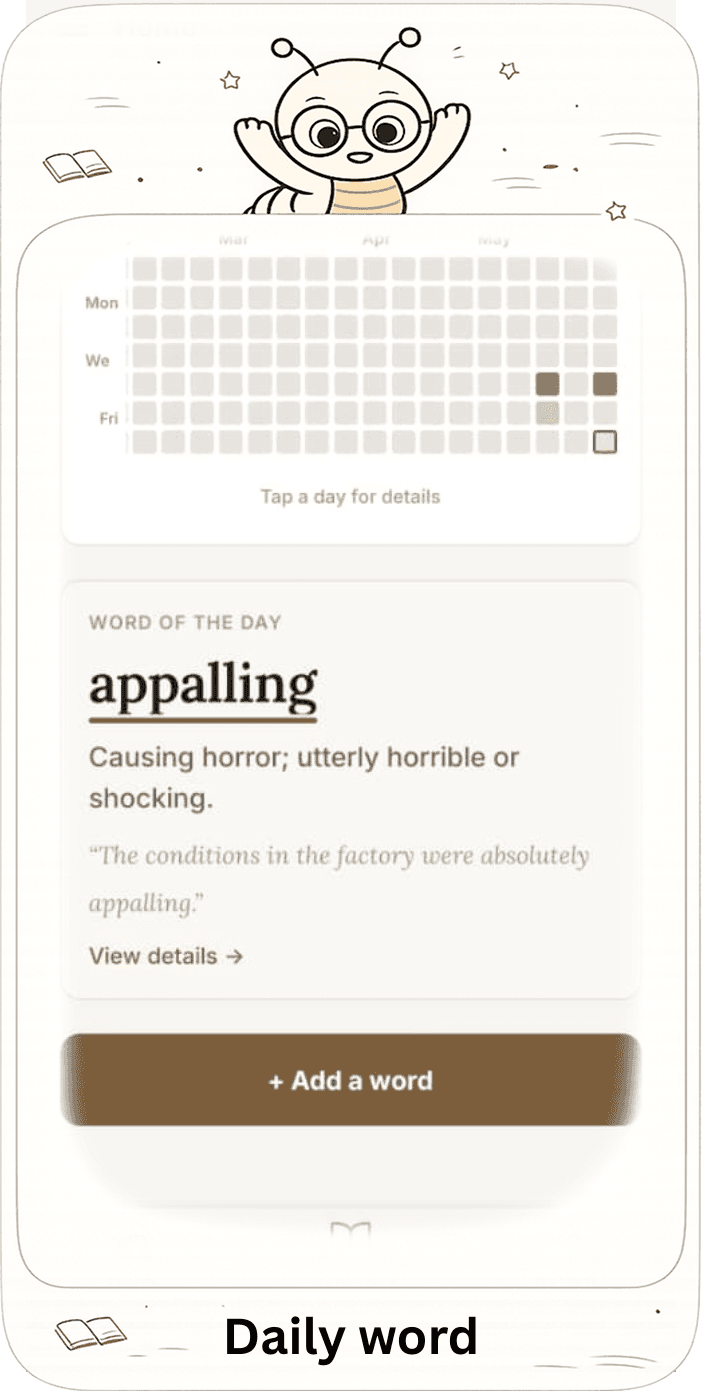
Mot du jour
- Met en avant un prompt quotidien pour rendre chaque retour dans l'app immédiatement utile.
- Affiche définitions, traductions et contexte dans une vue mobile compacte.
- Renforce l'habitude d'étude sans imposer une session complète de révision.
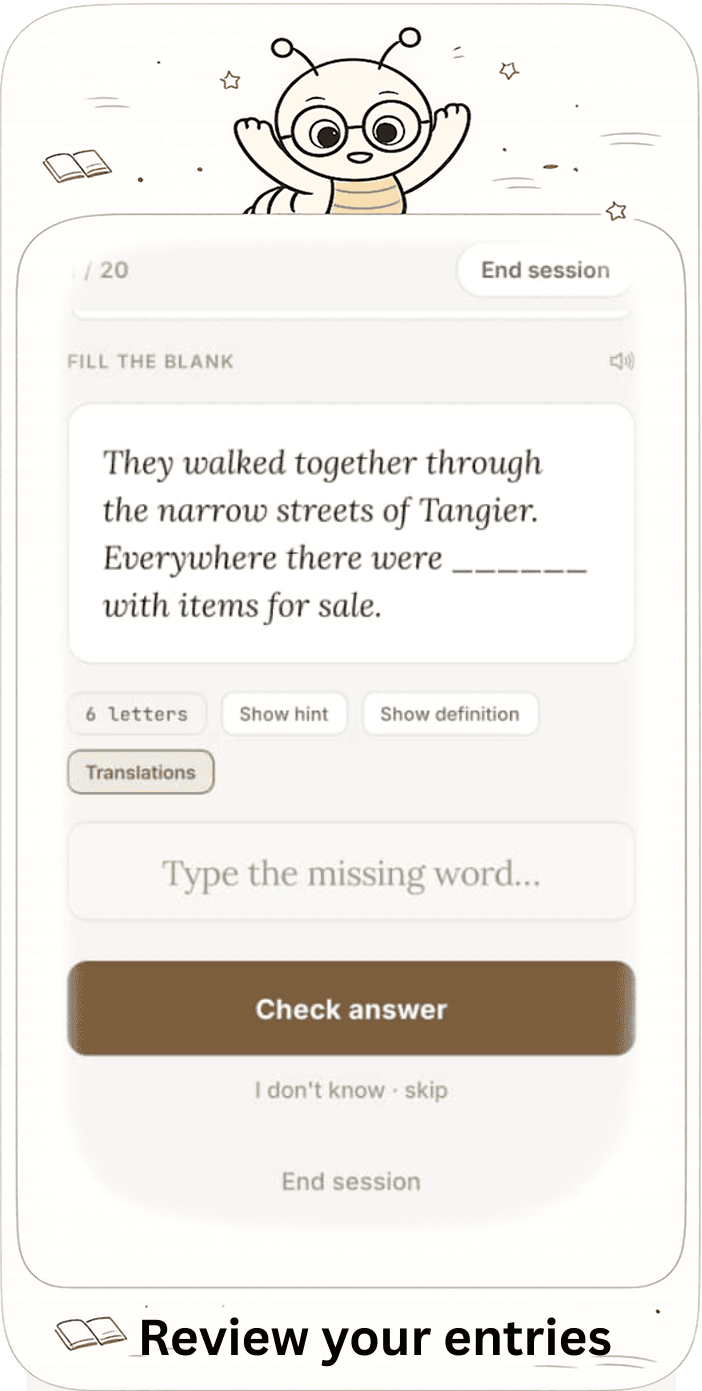
Réviser ses mots
- Le planning SM-2 priorise les mots dus au lieu d'une simple file de flashcards.
- Le flux de révision suit la qualité de rappel et met à jour automatiquement la prochaine date.
- Conçu pour soutenir la rétention quotidienne avec peu d'organisation manuelle.
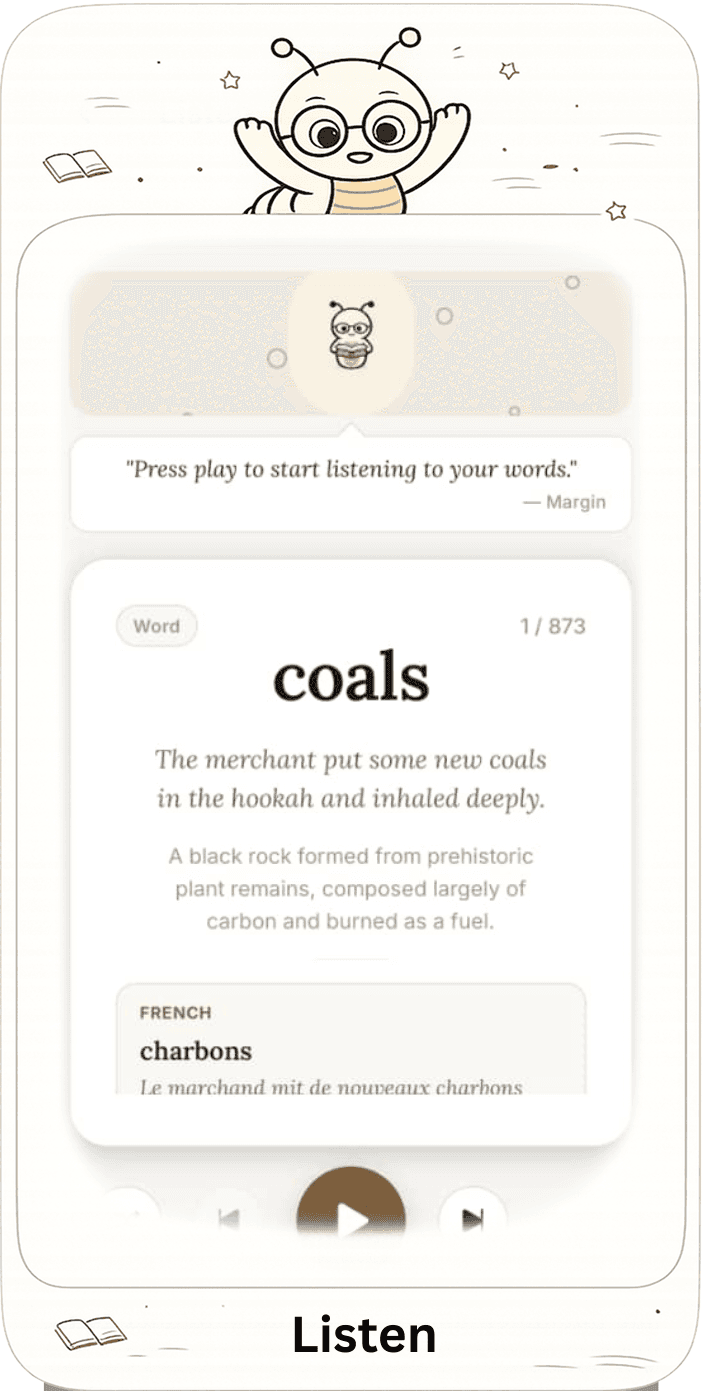
Mode écoute
- La narration podcast permet de réviser en marchant, en transport ou au repos.
- Lit les mots sauvegardés avec définitions et contexte, sans dépendre du temps d'écran.
- Réutilise les mêmes données de vocabulaire que le flux de révision visuel.
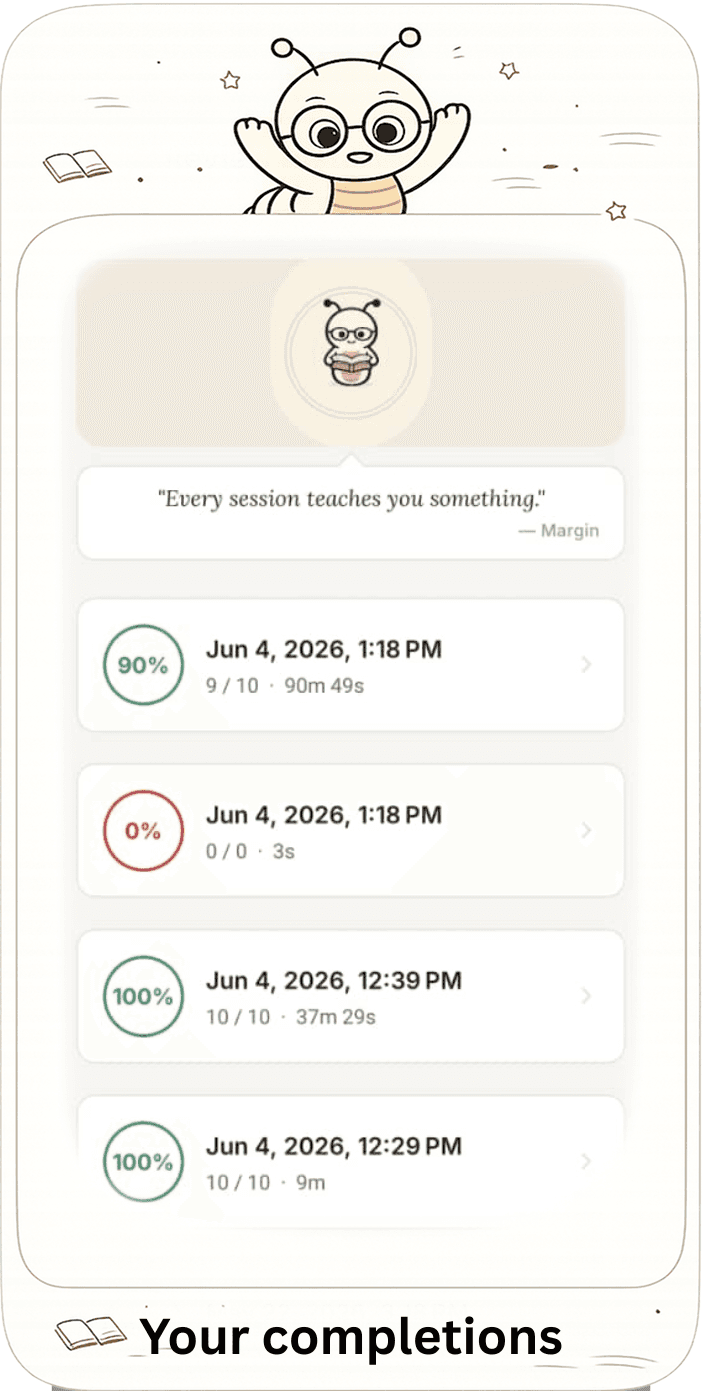
Statistiques d'apprentissage
- Les vues de progression résument l'activité de révision, les séries et la croissance du vocabulaire.
- Donne un retour clair sur la régularité et la rétention dans le temps.
- Garde les analytics personnelles en local avec le reste des données offline-first.
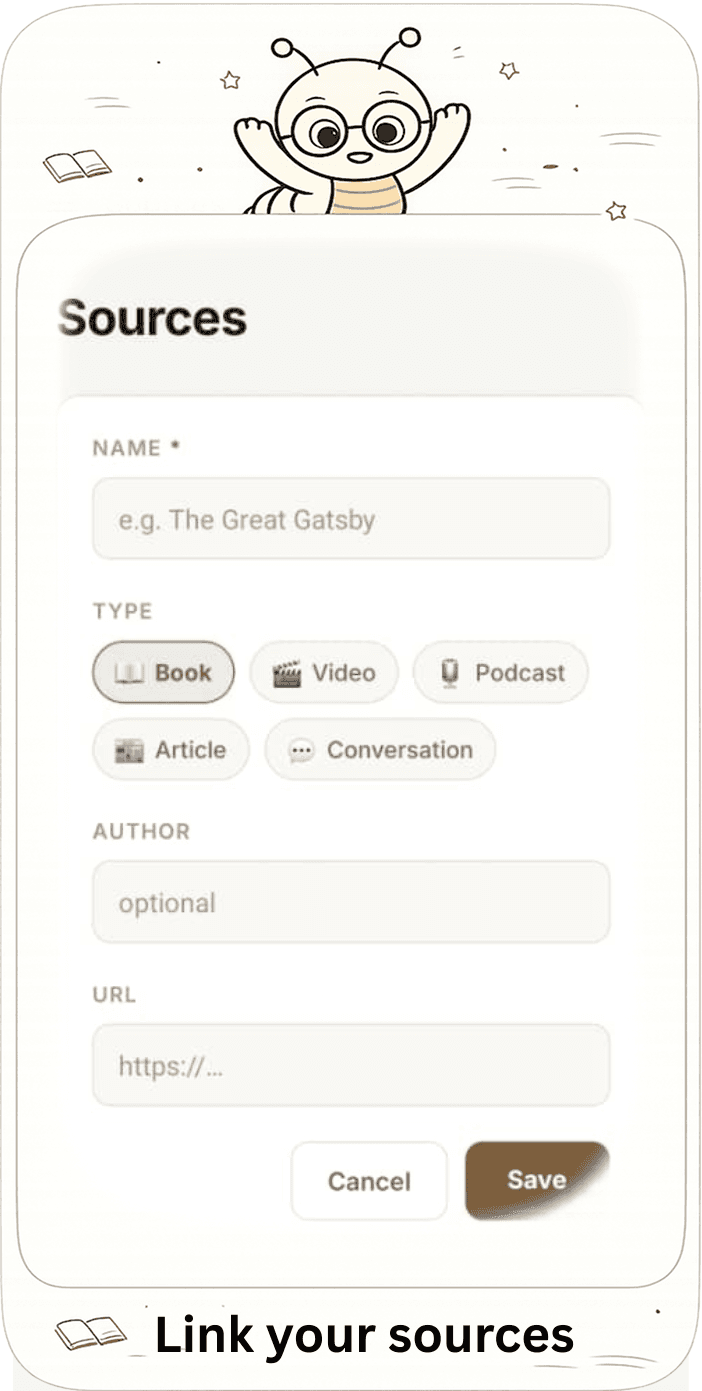
Organisation par source
- Les mots peuvent être groupés par source pour se rappeler d'où vient le vocabulaire.
- Supporte livres, articles, vidéos, cours ou tout contexte d'apprentissage personnalisé.
- Les métadonnées de source font partie du modèle domaine au lieu d'un simple tag UI.
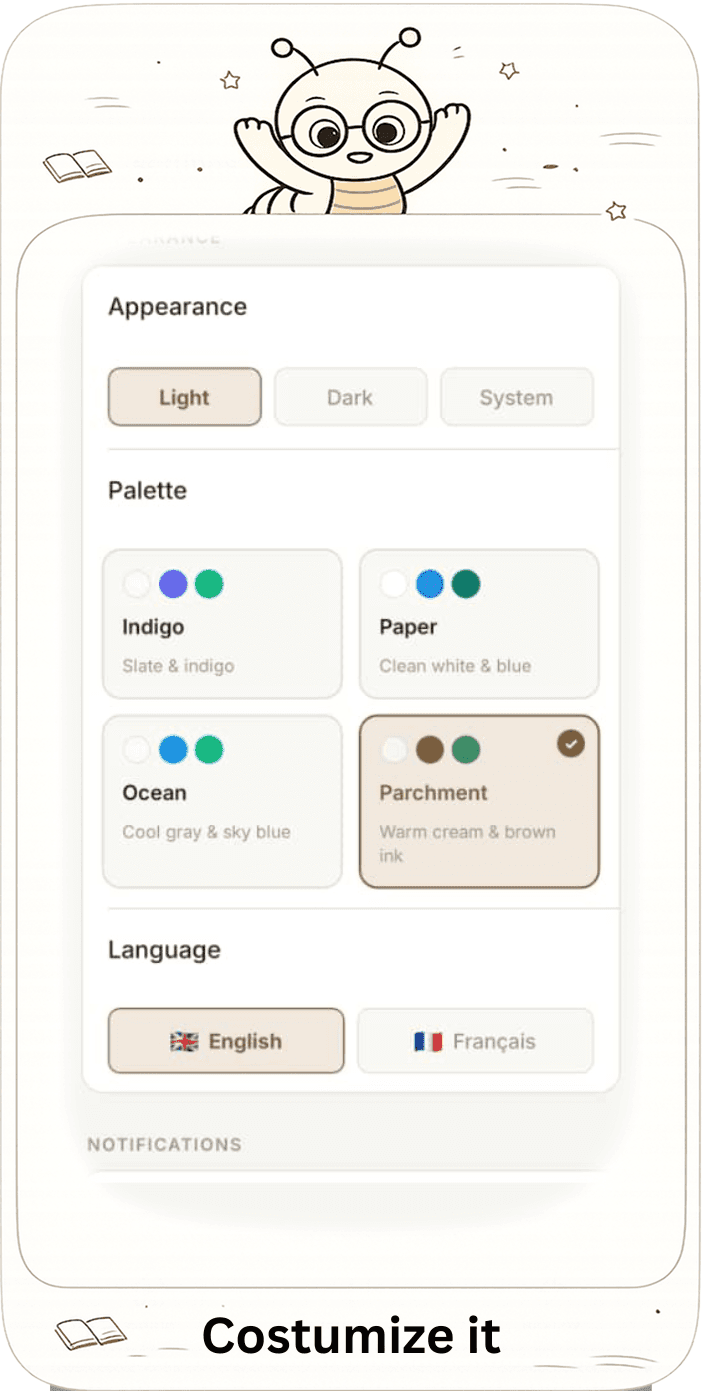
Sauvegarde offline-first et préférences
- Les workflows de sauvegarde et restauration utilisent une synchronisation ZIP sans dépendance cloud.
- Les préférences de langue et d'application sont accessibles depuis un écran de paramètres ciblé.
- Les implémentations stockage natif et web restent interchangeables derrière les interfaces partagées.
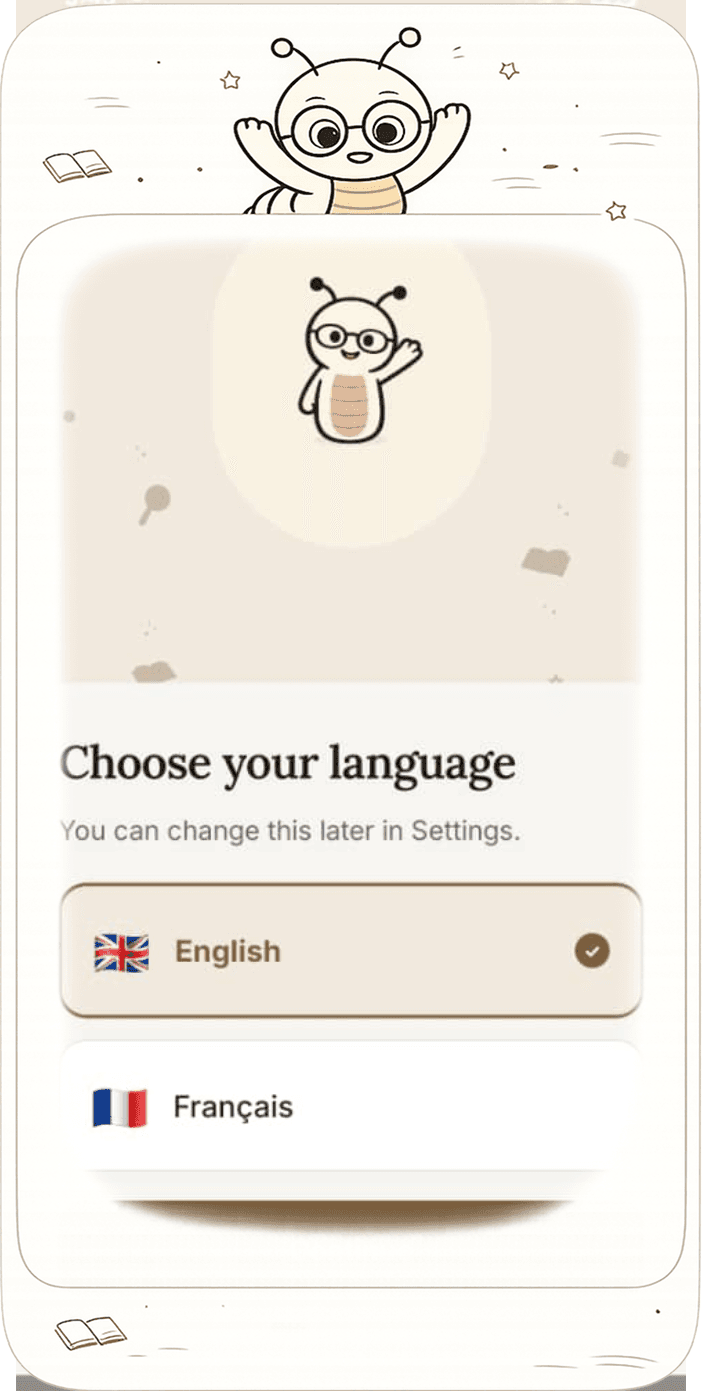
Choisir sa langue
- L'onboarding prend en charge l'anglais et le français dès le départ.
- Le choix de langue se connecte au workflow bilingue de vocabulaire.
- Garde la première expérience cohérente avec le périmètre bilingue du produit.
Notes d'implémentation
- Conçu et livré ce produit personnel pour résoudre mon propre workflow d'apprentissage du vocabulaire, de l'idée à la production sur Web et Android en solo.
- Déployé sur Web et Android depuis un seul codebase TypeScript en appliquant DDD et clean architecture, interchangeant SQLite (natif) et IndexedDB (web) derrière une interface de repository partagée.
- Implémenté l'algorithme de répétition espacée SM-2 planifiant les révisions quotidiennes et un mode narration podcast pour la révision passive mains-libres, maximisant la rétention dans de multiples contextes d'apprentissage.
- Conçu un système de sauvegarde offline-first avec compression ZIP, synchronisation push/pull incrémentale et bundling d'images, éliminant toute dépendance cloud et les coûts serveur.
Projets Phares
Open Source
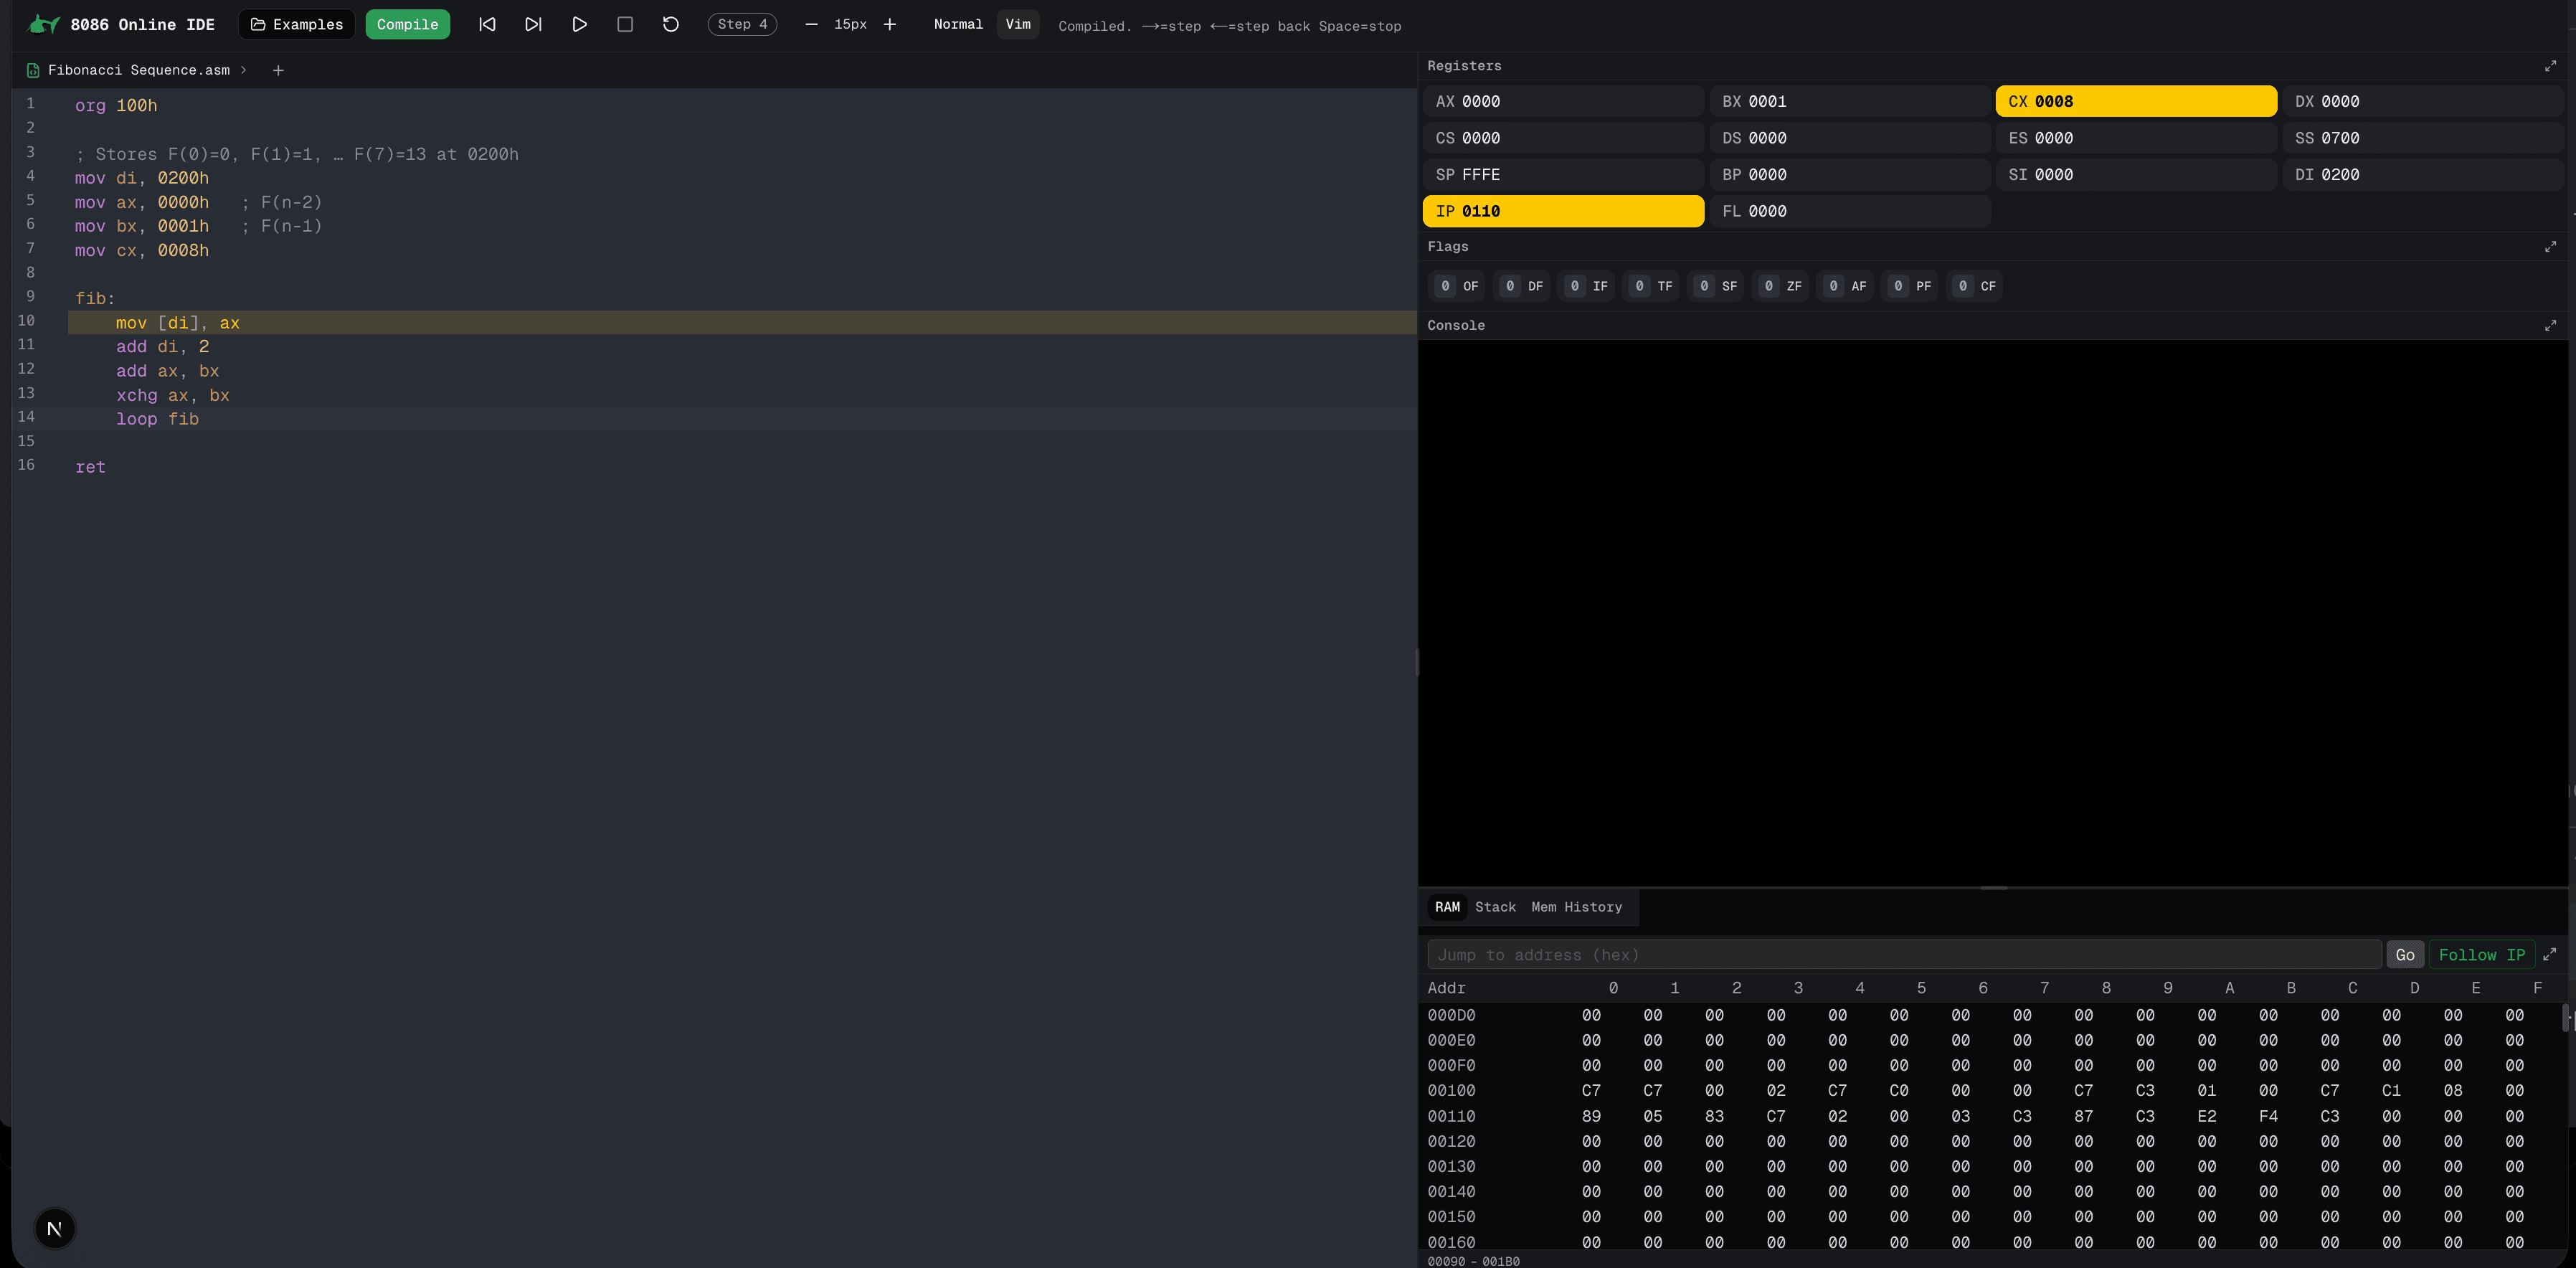
Émulateur Web du Processeur 8086
Émulateur et assembleur Intel 8086 open-source pour le navigateur (Vanilla JS), réalisé comme projet pluridisciplinaire de 2ᵉ année à l'université en équipe de 6, avec simulation du jeu d'instructions et débogage interactif.
- JavaScript
- HTML
- CSS
Projet de Thèse
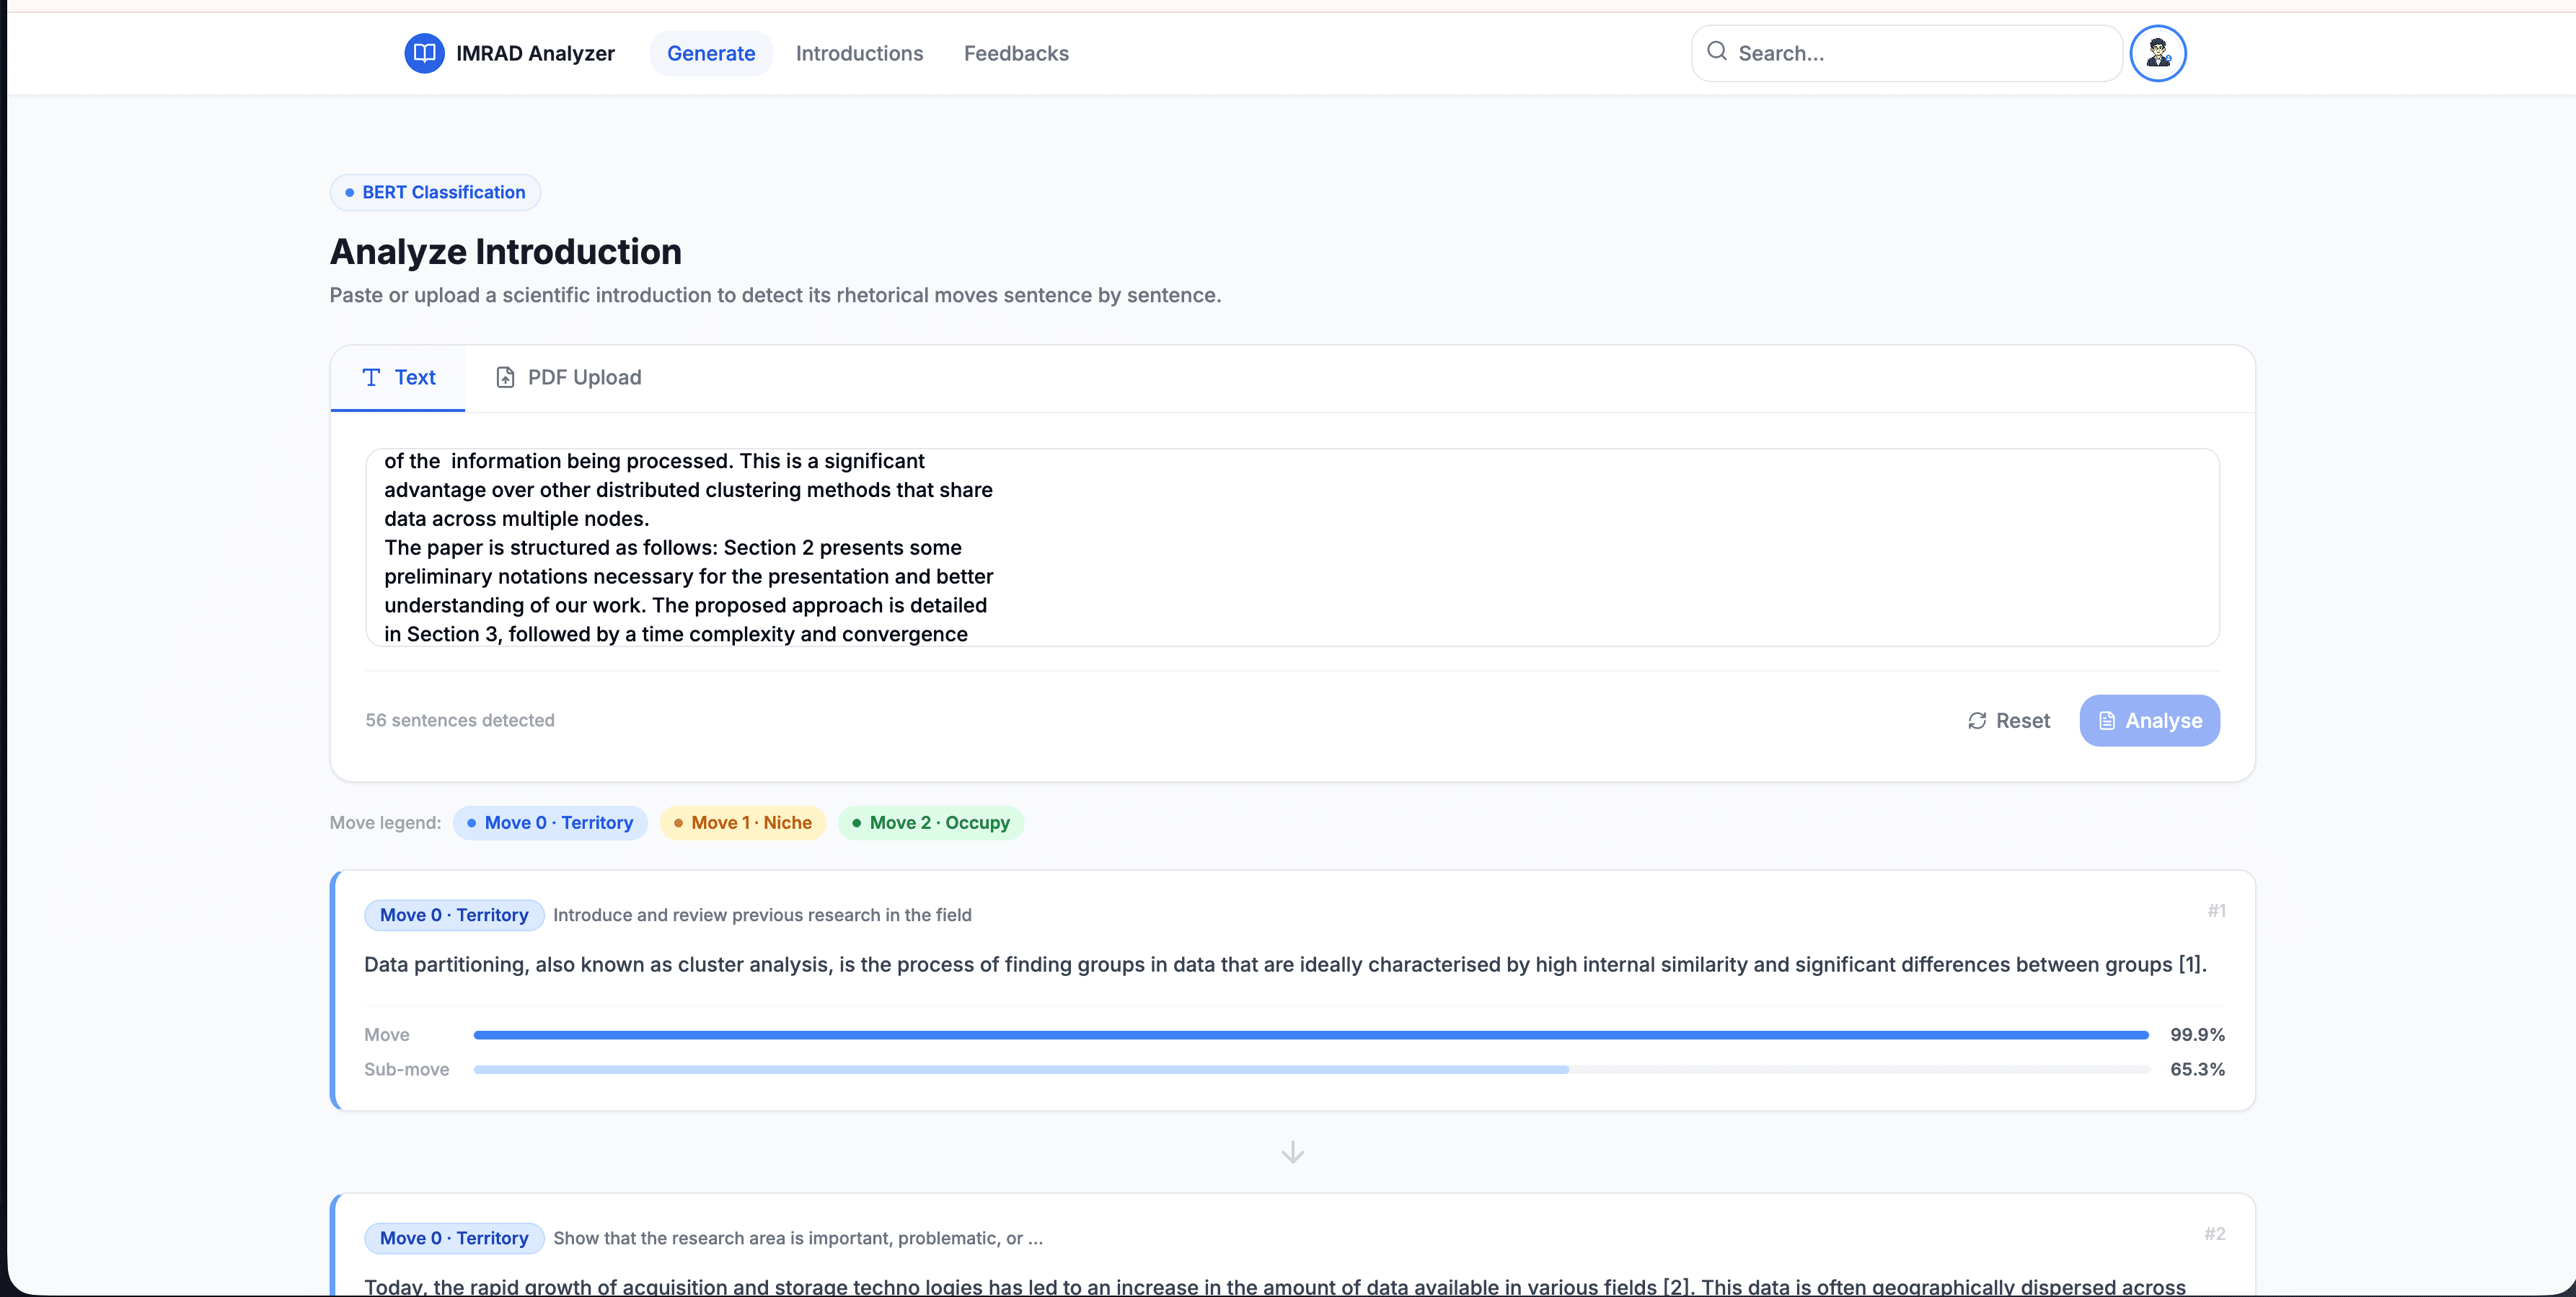
IMRaD Analyzer : Microservices Distribués pour la Classification de Textes Scientifiques
Une plateforme de 8 microservices exploitant BERT et Gemini Pro pour classifier des articles scientifiques, avec un dataset personnalisé de 169k phrases atteignant un F1-score de 98,21%.
- Next.js
- FastAPI
- BERT
- Gemini Pro
- TF Serving
Travaillons ensemble
Je suis actuellement ouvert à de nouveaux postes, en télétravail ou à l'international. Si vous construisez quelque chose d'ambitieux, j'adorerais en entendre parler.